This translation was generated by artificial intelligence. The original Spanish content is the primary reference.
13वीं शताब्दी में कैस्टिल एक शक्तिशाली साम्राज्य था लेकिन समुद्र की ओर नहीं देखता था। जब फर्डिनेंड तृतीय ने 1248 में सेविले पर कब्जा किया, तो उसे एक बंदरगाह मिला लेकिन कोई बेड़ा नहीं। अल्फोंसो दशम ने कैस्टिलियन एडमिरल्टी की स्थापना की और 1254 में पहला एडमिरल नियुक्त किया।
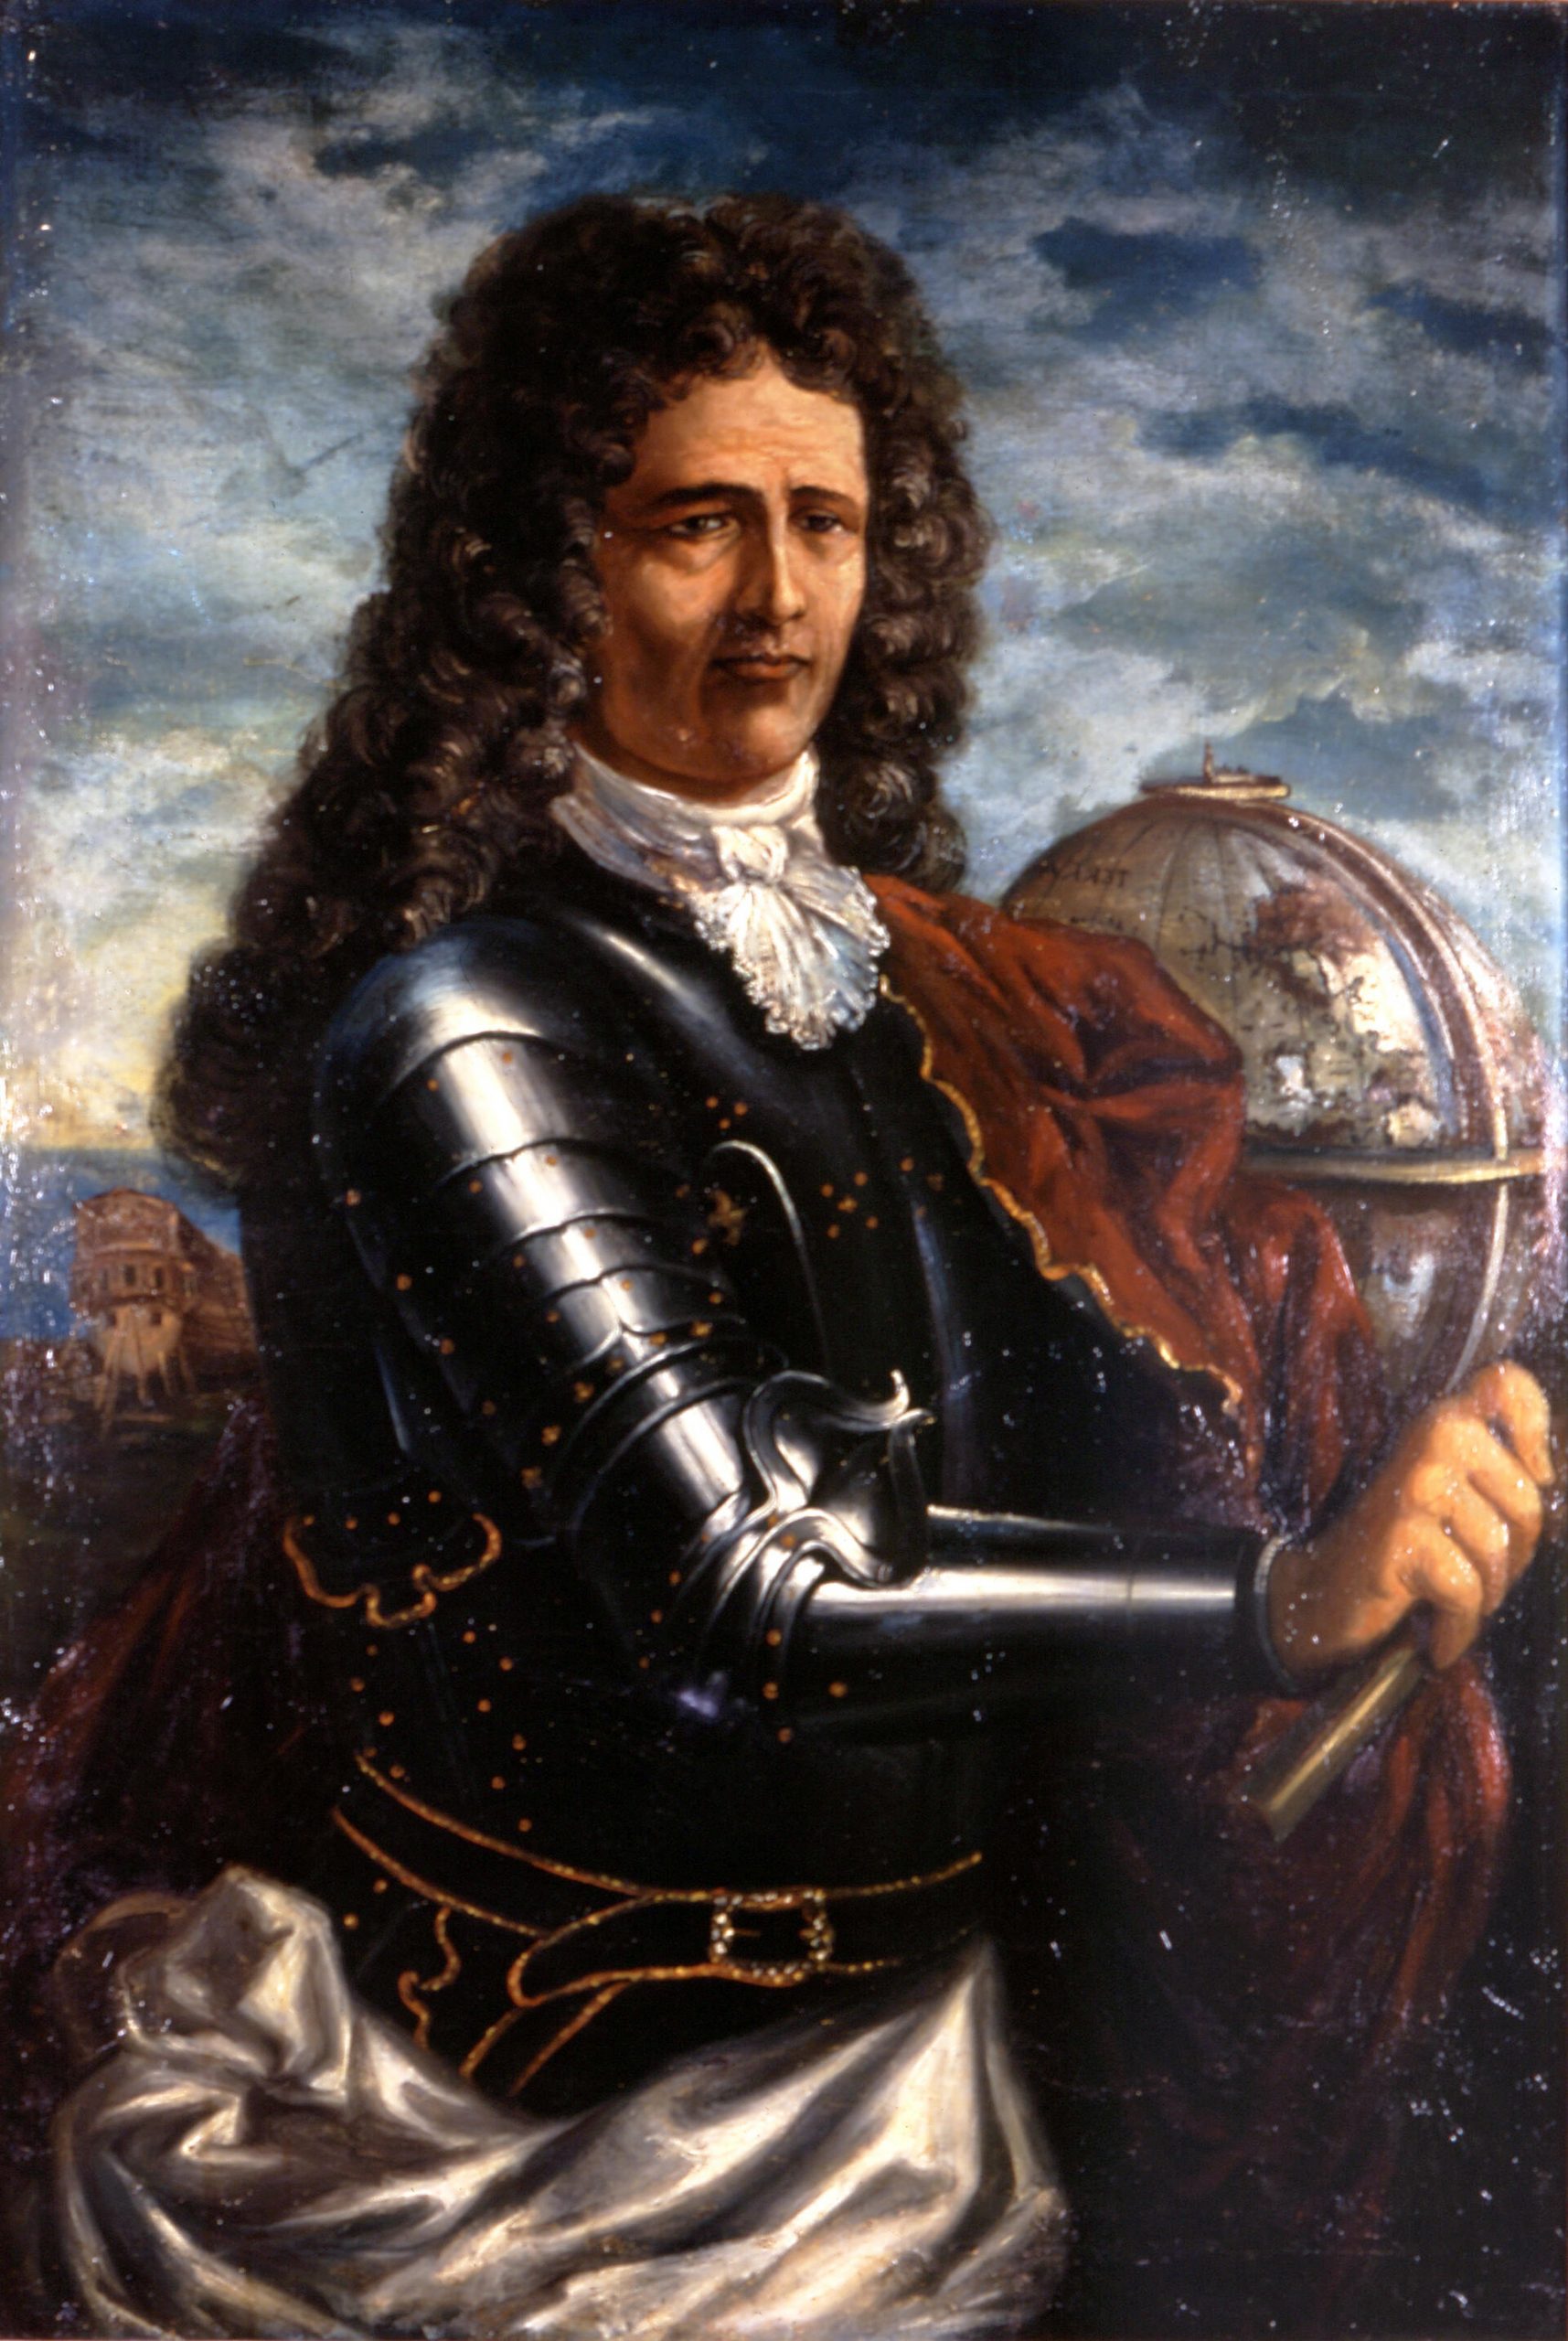
Antonio de Gaztañeta e Iturribalzaga (1656-1728) fue marino, almirante, constructor naval y superintendente de los arsenales. Su carrera combinó años de navegación en los buques de la Armada con una formación teórica que aplicó a la ingeniería naval. Felipe V lo nombró superintendente de los arsenales para materializar el plan de recuperación naval de los Borbones. En 1720 publicó Proporciones de las medidas más essempciales para la fábrica de navíos de guerra y mercantes, el manual de referencia de los astilleros hispanos durante casi medio siglo.
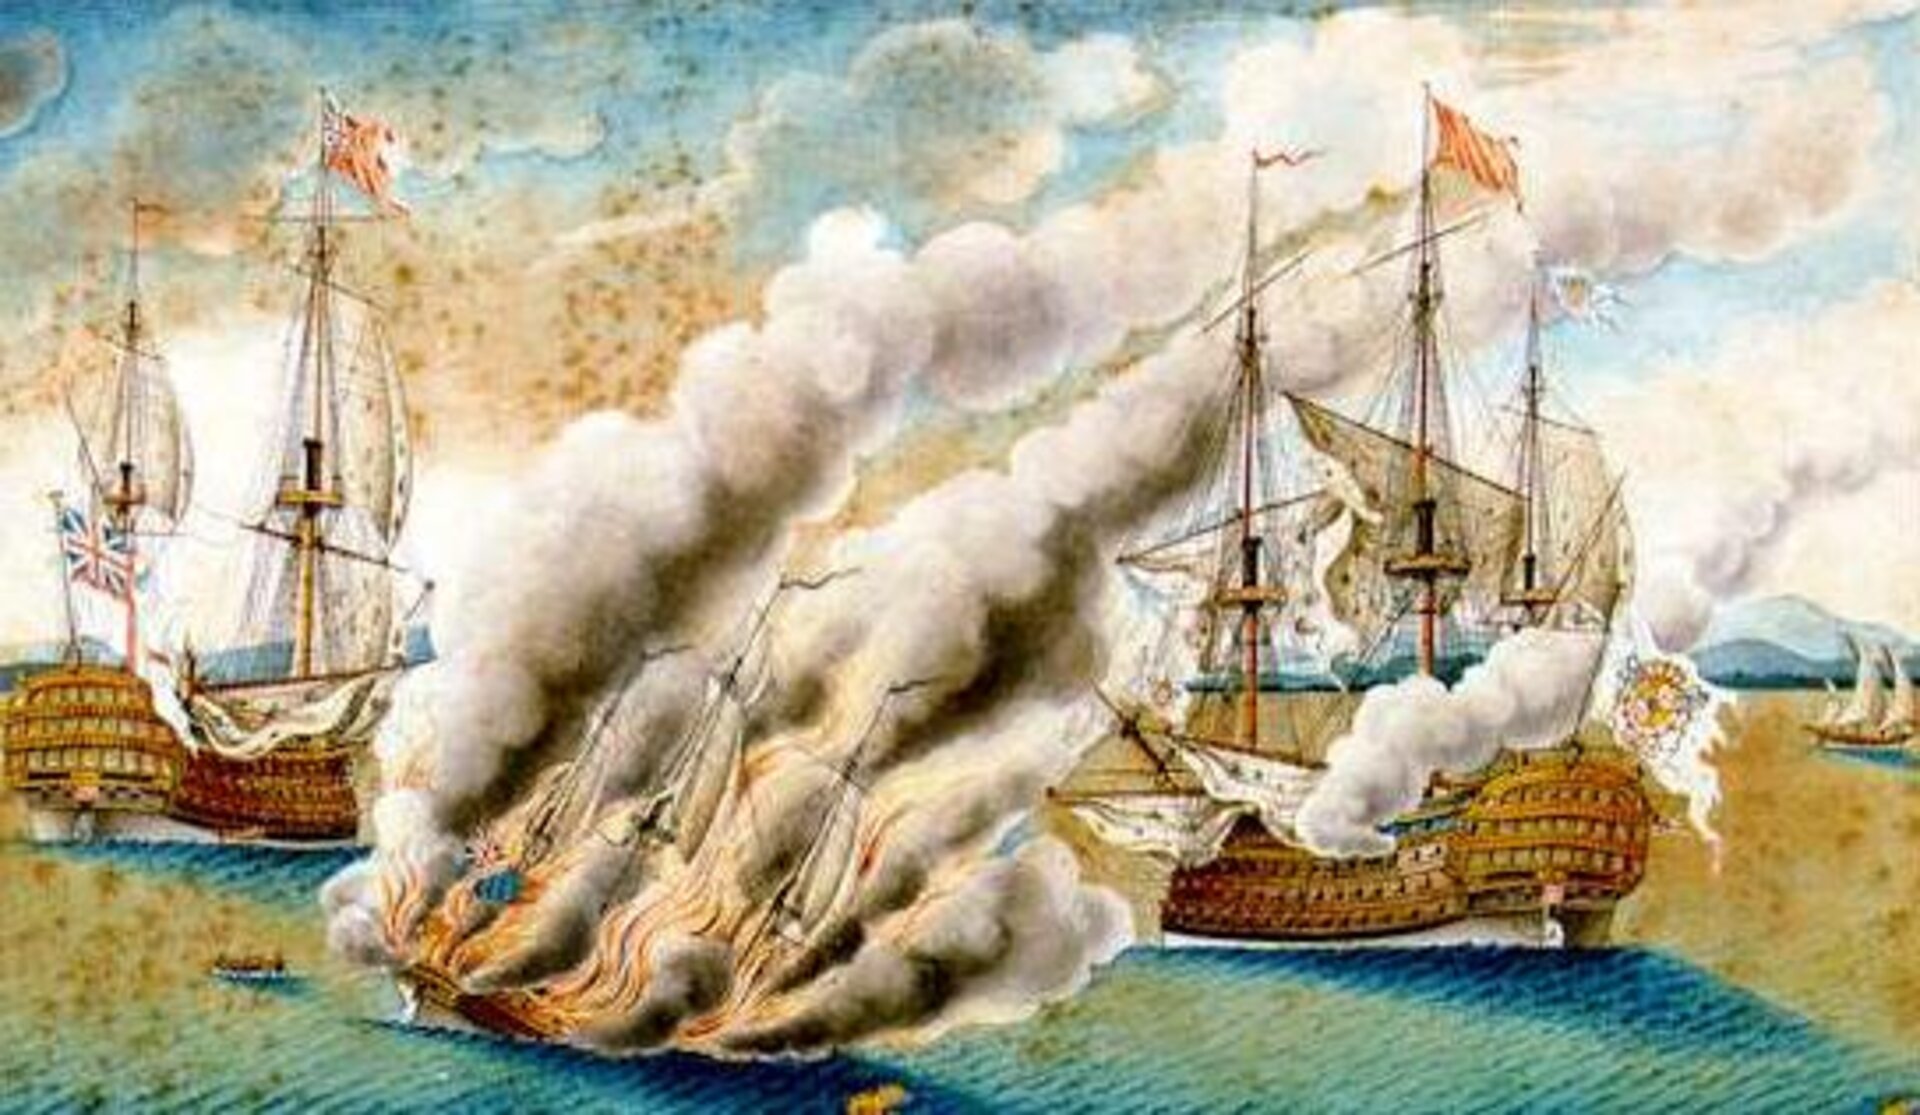
Combate de Tolón (1744). El navío Real Felipe, construido según el sistema Gaztañeta, destruye un brulote inglés. Museo Naval de Madrid.
Los antecedentes: la construcción naval antes de Gaztañeta
Antes de Gaztañeta, la construcción naval española se regía por la tradición empírica de los maestros de ribera. Cada astillero usaba sus propias proporciones y métodos, y los navíos salían con características muy dispares. Las derrotas de la Guerra de la Sucesión Española (1701-1714) dejaron clara la inferioridad técnica de los barcos españoles frente a los franceses e ingleses. Los Borbones necesitaban modernizar la Armada, y Gaztañeta fue el hombre encargado de hacerlo.
La RHN lo explica así: la carpintería de ribera pasó del arte empírico a la ciencia de la construcción naval. Antes del sistema Gaztañeta no existían planos normalizados, no había proporciones fijas entre eslora, manga y puntal. Cada astillero producía buques distintos, y eso hacía casi imposible mantenerlos o repararlos con piezas intercambiables.
El sistema Gaztañeta: proporciones y medidas
El sistema establecía proporciones fijas para todos los componentes del casco, basadas en la eslora, la manga y el puntal. Gaztañeta fijó la eslora en tres veces la manga, una proporción que buscaba el mejor compromiso entre velocidad, estabilidad y capacidad de carga. También definió las formas del codaste, la roda y todo el esqueleto del barco.
Clasificó los navíos por número de cañones: desde los de 60 hasta los de 74 y 80 cañones. El sistema incluía instrucciones precisas para cada elemento: el grosor de las cuadernas, la curvatura de la amura, la altura del puntal, la forma de la popa. Todo en planos y tablas que cualquier maestro de ribera podía seguir.
Gaztañeta se apoyó en los conocimientos de la tradición vasca y cántabra, pero los sistematizó con un rigor matemático que no se había visto antes en España. Según la RHN, sus trabajos resolvieron «las ambigüedades de métodos anteriores, dando a la Construcción Naval una uniformidad, hasta entonces inimaginable».
Todoavante añade que el sistema permitió por primera vez que astilleros de distintas provincias —de Guipúzcoa a La Habana— construyeran series homogéneas de buques. Un navío averiado en Cartagena podía repararse con piezas fabricadas en Ferrol, porque los planos eran los mismos.
La implementación en los astilleros
La aplicación empezó pronto. Según Todoavante, ya en 1716 se construyó en Santoña un navío de 60 cañones por Lorenzo de Arzueta siguiendo las trazas de Gaztañeta.
El primer gran navío de la nueva generación fue el Real Felipe, de 114 cañones y 2.163 toneladas, construido en los astilleros reales de Guarnizo (Santander) y botado en 1732. Fue el primer navío español de tres puentes, el mayor de su época. Participó en el combate de Tolón en 1744 y lo desguazaron en Cartagena en 1750.
Luego vinieron otros. El Princesa, de 70 cañones, construido en Guarnizo en 1730, protagonizó una de esas historias que merecen contarse. En abril de 1740 fue avistado por tres navíos ingleses: el Oxford, el Lennox y el Kent, también de 70 cañones. Con un navío contra tres y habiendo perdido un mastelero, el Princesa aguantó seis horas de combate antes de rendirse. Los oficiales ingleses se quedaron admirados de la solidez de su casco. Un capitán británico escribió que «sus baos y su tablazón lucían tan frescos como cuando fueron construidos». La Royal Navy estudió con atención sus cualidades: estabilidad, fortaleza estructural, buen comportamiento en la mar.
Los arsenales se organizaron según las Ordenanzas de 1721, que Gaztañeta ayudó a redactar. Se pusieron en marcha los de los tres Departamentos Marítimos: Ferrol (La Grana, desde 1726), Cádiz (La Carraca, 1724, por indicación de Gaztañeta y Patiño) y Cartagena, que se modernizó.
La Habana también fue clave. Allí se construyeron navíos del sistema Gaztañeta como el San Felipe (1745) y varios de los nueve encargados por el marqués de la Ensenada a partir de 1748. La madera americana —cedro y caoba— daba más durabilidad que los robles europeos, y los astilleros cubanos demostraron que el sistema valía tanto en el Caribe como en Cantabria.
Problemas y resistencias
No todo fue fácil. Los maestros de ribera se resistían a dejar sus métodos. El sistema Gaztañeta exigía saber leer planos y manejar números, y muchos maestros no tenían esa formación. La transición fue lenta y a veces conflictiva.
Además, el sistema no era perfecto. Algunos navíos salían con la popa demasiado pesada, lo que les restaba estabilidad y velocidad. La proporción de tres veces la manga no siempre daba los mejores resultados. Los barcos españoles tendían a ser más pesados y lentos que los ingleses o franceses, aunque también más robustos y duraderos.
Legado
Con todo, Gaztañeta fue el primero en aplicar un método racional y científico a la construcción naval española. Su sistema duró hasta bien entrado el siglo XVIII. Cipriano Autrán y Pedro Boyer continuaron su obra y publicaron sus propias reglas y proporciones en 1742. Jorge Juan lo perfeccionaría más tarde, después de estudiar la construcción naval inglesa durante su misión en Londres.
La RHN lo resume así: «Los buques construidos supusieron la consolidación de un método propio, basado en profundos conocimientos teóricos reducidos luego a soluciones puramente prácticas, que resuelven las ambigüedades de métodos anteriores».
El Museo Naval de Madrid conserva varios manuscritos y planos originales de Gaztañeta, además de una maqueta de uno de sus galeones realizada por Jesús María Perona. En la iglesia de la Asunción de Arcenillas (Zamora) hay un óleo de Martín Amigo que representa uno de sus galeones visto de babor y de popa. Gaztañeta no solo creó un sistema de construcción: creó una forma de pensar la ingeniería naval que duró generaciones.
Fuentes y recursos
Revista de Historia Naval, núm. 12, 1986: «Antonio de Gaztañeta y la construcción naval en el siglo XVIII», por José María Blanco Núñez.
Revista de Historia Naval, núm. 45, 1994: «Los sistemas de construcción naval españoles del siglo XVIII», por José Antonio Ocampo Aneiros.
CASTANEDO GALÁN, Juan M.: *Guarnizo, un astillero de la Corona*, Editorial Naval, Madrid, 1993.
Todoavante: artículos sobre los navíos *Real Felipe*, *Princesa* y la serie de 60 cañones construidos con el sistema Gaztañeta.
Museo Naval de Madrid: fondos documentales sobre construcción naval del siglo XVIII.
Archivo General de Indias: expedientes de construcción naval en astilleros americanos.
[^1]: Archivo General de Indias, Sección Contaduría, legajos 1234-1245. Registros de carenas y avituallamiento del Apostadero de La Habana, 1761-1762.’ mencionados.
>
—
# Tipos de aparejos y velas en los buques de guerra españoles: el pulmón de la Armada en el Caribe (La Habana, 1761-1762)
El **aparejo de un buque de guerra español del siglo XVIII** es el conjunto de palos, vergas, jarcias y velas que permite capturar la fuerza del viento para gobernar y navegar. En plena Guerra de los Siete Años, cuando la monarquía hispánica se jugaba el control del Atlántico, el astillero de La Habana —bajo la dirección del ingeniero **Juan de Montalvo**— se convirtió en el taller donde la teoría naval de Madrid se enfrentaba a la realidad tropical. Allí, entre 1761 y 1762, se carenaron tres embarcaciones que ejemplifican como pocas la evolución de los aparejos y velas en la Armada borbónica: las fragatas **Flecha** y **Flora**, y el paquebote **Marte**.
A través de sus bitácoras de carena podemos entender cómo coexistían las velas cuadras tradicionales, las innovaciones de cuchillo y el debate entre la cebadera y el foque. Este artículo no solo describe esas piezas, sino que las sitúa en el contexto de una potencia rearmándose en su astillero más preciado —el mismo donde ya se recibían planos para los nuevos [navíos de línea españoles](ENLACE_INTERNO: La evolución de los navíos de línea españoles en el siglo XVIII) de 80 cañones.
—
## 1. Montalvo y su forja tropical: el astillero de La Habana
Juan de Montalvo no era un mero administrador; era el ejecutor último de la política naval borbónica en el Caribe. Supervisaba desde la llegada de los planos de los futuros navíos de línea —diseñados por ingenieros de la escuela de Jorge Juan y Sánchez Carrión— hasta la compra de lona de algodón para las velas y la brea de pino para el calafateado. En 1761-1762, su astillero trabajaba a destajo: mientras se aserraban maderas duras para los monstruos de 80 cañones, tres unidades menores eran puestas en seco para recibir **carenas** (reparaciones del casco y la obra viva) y, en algunos casos, velamen nuevo.
La técnica de impermeabilización era vital en aguas caribeñas. La broa (broma) —un molusco xilófago— devoraba los cascos en meses si no se protegían con **betunes** y **calafateado**: hiladas de estopa embreada que se introducían a golpe de maza entre las tablas. Los documentos de la época, como los registros de la contaduría de La Habana[^1]
[^1]: Archivo General de Indias, Sección Contaduría, legajos 1234-1245. Registros de carenas y avituallamiento del Apostadero de La Habana, 1761-1762., mencionan «calafatear todos los costados, cubiertas, toldilla, castillo y amuradas», una labor que convertía al buque en una vasija estanca. Pero más allá de la supervivencia, estas carenas revelan cómo la Armada estaba afinando el **diseño de sus aparejos**.
Antes de diseccionar cada buque, conviene tener una visión panorámica de los tres protagonistas:
| Buque | Tipo | Velas provistas | Modificaciones estructurales |
|——-|——|—————-|——————————|
| Fragata *Flecha* | Fragata de tres palos | Mayor, velacho, mesana, cebadera, foque | Mastelero de gavia añadido; 25 baos nuevos en castillo, combés y entrepuentes |
| Fragata *Flora* | Fragata de tres palos | Trinquete, gavia, rastrera | Calafateo completo, betunes en 4 hiladas por banda, repintado integral |
| Paquebote *Marte* | Paquebote (bergantín o nieve, probable) | Ninguna registrada (solo carena) | Calafateo de costados, cubiertas, toldilla, castillo y amuradas |
—
## 2. La fragata *Flecha*: vanguardia de la vela cuadra y el foque
La *Flecha* era el paradigma de la fragata de tres palos de la década de 1760. Sometida a una **carena mayor** —la más exhaustiva de las tres—, se le renovó casi la mitad de la estructura: «25 baos nuevos distribuidos en castillo, combés y entrepuentes», según consta en los partes de Montalvo. Los baos son las vigas transversales que sostienen las cubiertas; su sustitución indica que el buque había sufrido esfuerzos extremos, probablemente en temporales atlánticos.
Pero lo que nos interesa es su **arboladura y velamen**. La *Flecha* recibió un **mastelero de gavia** en el palo mayor. No se trata de una vela, sino de un palo menor que se añade sobre el mastelero principal para izar la **gavia** (vela cuadra alta) y, eventualmente, los juanetes. Esta innovación, que ya era común en la Marina británica, permitía aumentar la superficie vélica sin alargar el palo mayor, mejorando la maniobrabilidad y la velocidad en vientos portantes.
El velamen provisto incluía cinco velas:
– **Mayor**: curso bajo del palo mayor.
– **Velacho**: gavia del trinquete (vela cuadra superior en el palo de trinquete). En la documentación de la época, el término «velacho» podía designar tanto una vela de estay como una vela cuadra; aquí se trata de esta última, acorde al uso habitual en fragatas.
– **Mesana**: vela de cuchillo o latina en el palo de mesana, aunque probablemente se rigiera ya por el reglamento de 1748 que tendía a la cangreja.
– **Cebadera**: vela cuadra que se izaba bajo el bauprés, ya en declive.
– **Foque**: vela triangular de estay que se largaba desde el bauprés hacia el trinquete, el futuro del aparejo de proa.
La coexistencia de **cebadera y foque** es un detalle técnico de primer orden. En 1762, la Armada española aún no había abandonado la cebadera, que daba estabilidad en rumbos de ceñida, pero el foque ya se abría paso como pieza más eficiente para navegar de bolina. La *Flecha* los montaba ambos, reflejando un momento de transición.
A continuación, un diagrama del aparejo de la *Flecha* basado en los registros de la carena:
«`mermaid
graph TD
subgraph «Palo trinquete»
T1[Verga de trinquete] –> V1[Trinquete curso bajo]
T2[Verga de velacho] –> V2[Velacho gavia del trinquete]
end
subgraph «Palo mayor»
M1[Verga mayor] –> VM[Mayor curso bajo]
MG[Verga de gavia] –> VG[Gavia vela cuadra alta]
MAST[Mastelero de gavia] –> MG
end
subgraph «Palo mesana»
ME[Entena de mesana] –> VME[Mesana latina o cangreja]
end
subgraph «Bauprés»
B1[Botalón de cebadera] –> CB[Cebadera vela cuadra]
B2[Botalón de foque] –> FQ[Foque triangular de estay]
end
«`
*Nota: No se muestran posibles juanetes, contrafoque o estays, pues solo constan las velas suministradas en esta carena.*
—
## 3. La fragata *Flora*: el enigma de la rastrera y el oficio del pintado
Frente a la reconstrucción casi total de la *Flecha*, la *Flora* recibió una **carena de mantenimiento**. El documento habla de «calafatear completamente» el casco y aplicar «betunes en cuatro hiladas por banda», además de un repintado integral. Estas labores no son meramente estéticas: la pintura con albayalde y minio protegía la madera de la intemperie y la broma, mientras los betunes sellaban las juntas.
Pero donde la *Flora* ofrece más jugo histórico es en su **velamen provisto**: solo tres velas, según el registro:
– **Trinquete**: curso bajo a proa.
– **Gavia**: vela cuadra alta en el palo mayor.
– **Rastrera**.
El término **rastrera** es un quebradero de cabeza para los historiadores navales. ¿Qué era exactamente? Las hipótesis principales son:
1. **Rastrera de gavia**: una vela cuadra adicional que se largaba por debajo de la gavia para aumentar superficie en vientos portantes.
2. **Vela de cuchillo de mesana**: una pequeña vela triangular que se añadía al palo de mesana para mejorar la estabilidad.
3. **Estay baja**: una vela triangular izada entre el palo mayor y el trinquete.
Sin documentos de diseño que aclaren su posición exacta, la interpretación más plausible —siguiendo las reglas de la época y la tendencia a optimizar el aparejo para vientos portantes— es que se tratara de una **vela de cuchillo auxiliar** en el palo mayor o mesana. Lo que sí sabemos es que la *Flora* no recibió un mastelero de gavia nuevo; quizás ya lo tenía, quizás no. La incertidumbre forma parte del oficio del historiador.
La *Flora* representa la cara pragmática de la Armada: reparar lo justo, pintar para proteger, y dotar solo las velas esenciales para cumplir su misión —probablemente correo o exploración entre La Habana y Veracruz.
—
## 4. El paquebote *Marte*: la incógnita silenciosa de dos palos
El *Marte* introduce una tipología distinta: el **paquebote**, una embarcación menor de dos palos, destinada al transporte de pliegos, paquetes y pasajeros urgentes. En esta campaña, solo fue calafateado; no consta provisión de velamen nuevo. Esto sugiere que su aparejo anterior era suficiente o que la prioridad era devolverlo al agua cuanto antes.
¿Cómo era su aparejo original? La documentación no lo explicita, pero las reglas navales de la década de 1760 apuntan a dos posibilidades:
– **Bergantín**: dos palos con velas cuadras en ambos (trinquete y mayor) y una cangreja en el mayor. Era el aparejo más común para embarcaciones rápidas y maniobreras.
– **Nieve**: similar al bergantín, pero con un pequeño mástil a popa del mayor para cangreja y, a veces, una mesana de cuchillo.
La falta de datos convierte al *Marte* en un enigma: sabemos que fue puesto a punto para navegar, pero desconocemos su silueta exacta al zarpar. Esa omisión, sin embargo, nos recuerda que la historia naval está hecha tanto de certezas como de vacíos que la imaginación del investigador debe llenar con prudencia.
—
## 5. Conclusión: el dibujo de un futuro en 80 cañones
Las carenas de la *Flecha*, la *Flora* y el *Marte* no fueron operaciones aisladas. Ocurrieron mientras sobre la mesa de Juan de Montalvo reposaban los planos de los nuevos **navíos de 80 cañones** enviados desde Madrid —diseños que integraban las lecciones de Jorge Juan sobre carenas más hidrodinámicas y aparejos optimizados. La convivencia entre la urgencia táctica (mantener las unidades menores operativas) y la ambición estratégica (construir los gigantes del futuro) define la pujanza del astillero de La Habana.
Desde un punto de vista técnico, estas tres naves muestran una Armada en transición: la **cebadera** aún no desaparece, pero el **foque** ya es estándar en las fragatas modernas; el **mastelero de gavia** se incorpora para aumentar la velocidad; y velas de cuchillo como la **rastrera** se ensayan para sacar partido a los vientos alisios. El olor a brea, el crujir de los 25 baos nuevos de la *Flecha* y el repintado de la *Flora* materializan la evolución de la Armada borbónica en el Caribe, justo antes de que el imperio español perdiera La Habana en 1762
1. Por qué el 10-K sigue siendo el documento más importante
El 10-K es el informe anual que toda empresa cotizada en Estados Unidos presenta ante la SEC. A diferencia del informe a accionistas —un documento de marketing con gráficos bonitos—, el 10-K es un documento legal con consecuencias penales si contiene información falsa o engañosa. Para el inversor serio, es la fuente primaria de información.
Sin embargo, la mayoría de los inversores minoristas nunca lo leen. Su extensión (entre 100 y 300 páginas) y su lenguaje jurídico disuaden incluso al más aplicado. Pero no es necesario leerlo entero: la clave está en saber qué secciones contienen la información que realmente importa y cómo interpretarla. Este artículo propone una metodología de lectura selectiva que permite extraer lo esencial en menos de una hora.
2. Dónde encontrar el 10-K y cómo navegarlo
Todos los 10-K están disponibles gratuitamente en EDGAR, el sistema de la SEC: https://www.sec.gov/cgi-bin/browse-edgar. Busca por ticker o nombre de empresa, selecciona «10-K» en el tipo de formulario, y elige el año más reciente.
Dos consejos prácticos:
– Usa el índice HTML. La SEC exige un índice interactivo al principio. No descargues el PDF: el HTML indexado te permite saltar entre secciones con un clic.
– Busca por palabras clave. En lugar de leer, usa Ctrl+F con términos como «however», «although», «risk», «goodwill», «material weakness» — son los marcadores de problemas.
– XBRL es tu aliado. Desde 2009, los 10-K incluyen etiquetas XBRL que permiten extraer datos financieros estructurados. Herramientas como `sec-edgar-api` (Python) o `XBRLReader` descargan balances y cuentas de resultados directamente en una hoja de cálculo.
La mayoría de las empresas publican el 10-K entre 60 y 90 días después del cierre fiscal. Para empresas con cierre en diciembre, eso significa que el 10-K suele estar disponible entre finales de febrero y finales de marzo.
3. Las tres secciones imprescindibles
De las 15 secciones (Items) que componen un 10-K, solo tres merecen una lectura atenta. El resto son plantillas legales repetitivas.
Item 1 — Business (Descripción del negocio): Aquí la empresa explica cómo gana dinero. Lo relevante no es lo que dice, sino lo que omite. Si una compañía describe su negocio en términos vagos («somos líderes en soluciones integrales…») sin detallar fuentes de ingresos concretas, es una señal de alerta. Busque descripciones específicas de segmentos, clientes principales, canales de distribución y estacionalidad.
Un ejemplo clásico: en el 10-K de 2019 de Kraft Heinz, el Item 1 describía su negocio como «uno de los mayores fabricantes de alimentos y bebidas del mundo» sin mencionar que el 40% de sus ingresos dependía de solo tres marcas en declive. Los inversores que leyeron esto antes de la caída del 70% en 2020 vieron las señales.
Item 7 — Management Discussion & Analysis (MD&A): Es la sección donde la dirección explica los resultados financieros del año. Lo más valioso es la comparativa interanual: ¿el crecimiento es orgánico o por adquisiciones? ¿Los márgenes mejoran por eficiencia real o por trucos contables (como cambios en estimaciones de vida útil de activos)? Preste atención al lenguaje matizado: «although» y «however» suelen preceder a las malas noticias.
Warren Buffett recomienda leer esta sección para hacerse una idea de cómo piensa y comunica la dirección. Si el CEO dedica tres párrafos a explicar por qué los resultados fueron malos «por factores externos», y un solo párrafo a los aciertos del año, tienes una pista sobre su estilo de gestión.
Item 1A — Risk Factors: La lista de riesgos que la empresa declara formalmente. No se trata de leer los 50 riesgos genéricos (todo 10-K incluye «riesgo de recesión global» o «riesgo de ciberataque»), sino de identificar los riesgos específicos de ese negocio. Si una empresa menciona «dependencia de un solo proveedor» o «concentración en un mercado regulatorio cambiante», eso es un riesgo real.
Lo más interesante del Item 1A es la evolución año a año. Compara los riesgos del 10-K actual con los del año anterior. Si aparece un riesgo nuevo que no estaba antes (por ejemplo, «investigación regulatoria en curso» o «deterioro de relaciones con cliente clave»), eso es una señal de alerta inmediata.
4. Señales de alerta en las notas a los estados financieros
Las notas contables (Notes to Financial Statements) son donde se esconden los problemas. Tres puntos críticos:
Reconocimiento de ingresos (Revenue Recognition): Si una empresa reconoce ingresos antes de entregar el producto o servicio, puede estar inflando resultados. Compare el flujo de caja operativo con el beneficio neto: si el beneficio crece pero el flujo de caja no, hay algo que no cuadra. Esto fue exactamente lo que ocurrió con Wirecard antes de su colapso en 2020: beneficios récord, flujo de caja negativo.
Goodwill y activos intangibles: Cuando una empresa paga más que el valor contable en una adquisición, la diferencia se registra como fondo de comercio (goodwill). Si el goodwill supone más del 50% del patrimonio neto, cualquier deterioro futuro golpeará el balance con dureza. La fusión AOL-Time Warner (2001) es el caso de libro: 44.000 millones de dólares en goodwill que se esfumaron en dos años.
Contingencias legales: Muchas empresas ocultan en notas las disputas judiciales que podrían ser materiales. Busque referencias a «posible pérdida» o «razonablemente posible» en la sección de compromisos y contingencias. También revise el Item 3 (Legal Proceedings), que a menudo se pasa por alto. Si hay litigios por propiedad intelectual, responsabilidad de producto o prácticas anticompetitivas, el impacto puede ser devastador.
5. Diferencias clave entre el 10-K y otros informes
Aspecto
10-K (Anual)
10-Q (Trimestral)
8-K (Eventos)
Frecuencia
Anual
Trimestral
Cuando ocurre
Auditoría
Auditado
No auditado
No aplica
Detalle
Máximo
Resumido
Puntual
Plazo entrega
60-90 días
40-45 días
4 días hábiles
Secciones
15 Items
10 Items
Variables
El 10-Q no está auditado, así que los inversores serios basan sus decisiones en el 10-K y usan los 10-Q para seguimiento.
6. La checklist del inversor en 10 pasos
1. Buscar el Item 7 (MD&A) y leer las secciones de resultados y perspectivas.
2. Comparar ingresos, beneficio operativo y flujo de caja libre de los últimos 3-5 años.
3. Identificar la tendencia de márgenes brutos y netos.
4. Revisar la deuda neta y la estructura de vencimientos.
5. Calcular el ratio de apalancamiento (deuda total / EBITDA).
6. Leer los riesgos específicos del Item 1A (saltándose los genéricos).
7. Verificar si ha habido cambios en la política de reconocimiento de ingresos.
8. Analizar la composición del goodwill y activos intangibles.
9. Buscar contingencias legales materiales en las notas.
10. Leer el informe del auditor (Item 9A): si hay «debilidad material» en controles internos, salir corriendo.
7. Herramientas prácticas para acelerar el análisis
No hace falta leer 300 páginas a mano. Estas herramientas extraen lo esencial en segundos:
– SEC EDGAR Full-Text Search — Busca cualquier palabra en todos los 10-K presentados en EE.UU.
– Dataroma — Extrae las carteras de los grandes inversores (Berkshire, Pershing Square, etc.) y enlaza directamente a sus 10-K.
– SimplyWallStreet — Visualiza los datos financieros clave de cualquier empresa cotizada.
– Python + sec-api — Scripts que descargan y analizan 10-K automáticamente. Puedes programar alertas cuando aparezcan palabras clave como «goodwill impairment» o «material weakness».
8. Cómo usar un LLM para analizar el 10-K por ti
Si no sabes interpretar algún dato del 10-K, o simplemente quieres ahorrar horas de lectura, puedes usar un asistente de IA (LLM) como DeepSeek, ChatGPT o Claude para que analice el documento por ti. La clave está en darle las instrucciones adecuadas — no vale pedirle «analiza este 10-K» sin más.
He diseñado tres prompts que cubren los 10 puntos de la checklist. Cada uno se centra en un aspecto distinto del análisis, porque un solo prompt con todo mezclado satura al modelo y pierde precisión.
Prompt 1: Análisis Cuantitativo, Márgenes y Tendencias Financieras
Cubre los puntos 2, 3, 5 y 8 de la checklist (métricas, márgenes, apalancamiento y activos intangibles). Copia y pega esto en el LLM junto con los estados financieros del 10-K:
Actúa como un Analista Financiero Senior y Consultor de Equity Research. Tu misión es extraer de forma milimétrica los datos cuantitativos clave del informe 10-K adjunto para evaluar la salud financiera, la trayectoria del negocio y la calidad de los activos de la compañía.
Estás auditando los estados financieros consolidados de la empresa (Income Statement, Balance Sheet y Cash Flow Statement) correspondientes a los últimos 3 a 5 años fiscales. Necesitamos aislar las métricas operativas y de balance fundamentales para detectar anomalías o deterioros estructurales.
Analiza el documento 10-K provisto y ejecuta los siguientes pasos de forma secuencial:
1. Localiza los estados financieros principales y extrae los datos de los últimos 3-5 años para las siguientes variables: Ingresos totales (Revenue), Beneficio Operativo (Operating Income / EBIT), Flujo de Caja Libre (Free Cash Flow, calculado como Operating Cash Flow menos CapEx).
2. Calcula y analiza la tendencia de los siguientes márgenes año a año:
3. Identifica en el balance el valor del Fondo de Comercio (Goodwill) y los Activos Intangibles. Localiza las notas asociadas para comprobar si ha habido algún cargo por deterioro (Impairment charge) en los periodos analizados y explica brevemente a qué unidad de negocio afectó.
4. Calcula el Ratio de Apalancamiento actual de la compañía. Sigue estrictamente este sub-paso de Chain of Thought:
a. Identifica la Deuda Total (Deuda a corto plazo + Deuda a largo plazo + Porción corriente de la deuda a largo plazo).
b. Calcula el EBITDA (EBIT + Depreciación y Amortización extraídas del Estado de Flujos de Cobre).
c. Muestra explícitamente la fórmula: Deuda Total / EBITDA y ejecuta el cálculo aritmético.
– Prohibido inventar o extrapolar datos. Si un dato de un año específico no está disponible en este reporte, indícalo explícitamente como «No reportado».
– Toda cifra monetaria debe incluir su divisa y especificar si está expresada en miles, millones o miles de millones.
– No omitas el paso de pensamiento aritmético del punto 4; muestra los números intermedios antes de dar el ratio final.
Presenta la información estructurada estrictamente bajo los siguientes encabezados de Markdown:
1. Evolución Histórica (Tabla comparativa de 3-5 años)
2. Análisis de Márgenes y Tendencias
3. Composición y Deterioro de Goodwill/Intangibles
4. Cálculo del Ratio de Apalancamiento (paso a paso)
[Pega aquí el texto de los Estados Financieros, Notas de Goodwill y Balance del 10-K]
Prompt 2: Análisis Cualitativo, MD&A y Cambios Contables
Cubre los puntos 1, 4, 7 y 9 (MD&A, perspectivas, estructura de deuda, reconocimiento de ingresos y contingencias):
Actúa como un Auditor de Cuentas y Consultor Forense de Finanzas. Tu objetivo es leer entre líneas en las secciones narrativas del 10-K para identificar la verdadera narrativa del equipo directivo, los compromisos de deuda reales y posibles técnicas de manipulación contable.
Las notas al pie y la discusión de la gerencia suelen ocultar los riesgos más severos de una empresa.
Examina el documento e interpreta la información realizando las siguientes tareas:
1. Analiza el Item 7 (MD&A). Sintetiza los factores principales que impulsaron los resultados del último año y detalla cuáles son las perspectivas operativas declaradas explícitamente por la dirección.
2. Revisa la Nota de Deuda. Extrae y mapea la estructura de vencimientos de la deuda neta (cuánto vence en el Año 1, Año 2, Año 3-5 y más de 5 años) junto con los tipos de interés asociados.
3. Examina la Nota 1 (Resumen de Políticas Contables). Determina si ha habido algún cambio reciente en la política de Reconocimiento de Ingresos.
4. Rastrea la nota de Compromisos y Contingencias. Extrae cualquier litigio legal o contingencia material pendiente.
INFORME DE AUDITORÍA CUALITATIVA
A. Interpretación del MD&A y Perspectivas del Negocio
B. Perfil de Vencimientos de la Deuda
C. Política de Reconocimiento de Ingresos y Alertas Contables
D. Contingencias Legales Materiales
[Pega aquí el texto del Item 7 MD&A y las Notas de Deuda, Políticas e Ingresos]
Prompt 3: Escudo de Riesgos, Controles Internos y Alertas Rojas
Cubre los puntos 6 y 10 (riesgos del Item 1A y controles internos del Item 9A):
Actúa como un Gestor de Riesgos de un Fondo de Cobertura especializado en Análisis Short. Tu único objetivo es encontrar razones de peso por las cuales deberíamos descartar la inversión en esta compañía.
Buscamos el peor escenario posible. Evaluar si la viabilidad operativa o la integridad del reporte financiero están comprometidas.
1. Analiza el Item 1A (Risk Factors). Filtra y descarta los riesgos genéricos de mercado. Identifica y extrae exclusivamente los 5 riesgos específicos, operativos, regulatorios o tecnológicos que sean únicos de esta empresa.
2. Dirígete al Item 9A (Controls and Procedures). Determina si el auditor o la administración han identificado alguna «Debilidad Material» en los controles internos. Si se detecta, detalla en qué proceso se localiza y emite una recomendación explícita de «ALERTA CRÍTICA».
REPORTE DE GESTIÓN DE RIESGOS
> [ ALERTA si hay debilidad material en Item 9A]
1. Riesgos Específicos (Item 1A – Top 5)
2. Evaluación de Controles Internos (Item 9A)
[Pega aquí el texto del Item 1A y del Item 9A / Informe del Auditor]
Por qué este enfoque funciona
– Modular: Dividir 10 puntos en 3 prompts evita que el modelo ignore instrucciones intermedias.
– Delimitadores claros: Las etiquetas \ separan las órdenes de los datos financieros.
– Chain of Thought: En el cálculo de apalancamiento, el prompt fuerza al modelo a desglosar cada paso, mitigando errores aritméticos.
– Filtros negativos: El Prompt 3 ordena ignorar riesgos genéricos, evitando respuestas llenas de tópicos.
Pega cada prompt en el LLM de tu elección junto con el texto de la sección correspondiente del 10-K. En cinco minutos tendrás un análisis que te habría llevado tres horas hacer a mano.
Fuentes y recursos
– SEC (2024). How to Read a 10-K. U.S. Securities and Exchange Commission. https://www.sec.gov/reportspubs/investor-publications/investorpubsinfo4a.htm
– Dorsey, P. (2008). The Little Book That Builds Wealth. Wiley.
– Greenblatt, J. (2010). The Little Book That Still Beats the Market. Wiley.
– Damodaran, A. (2012). Investment Valuation. 3rd ed. Wiley.
– Buffett, W. (1984). «The Superinvestors of Graham-and-Doddsville». Hermes (Columbia Business School Magazine).
– SEC EDGAR: https://www.sec.gov/edgar/search/
Sugerencia de imagen
Infografía de una página con las secciones clave del 10-K representadas como iconos: un edificio (Item 1: negocio), una lupa (Item 7: MD&A), un escudo (Item 1A: riesgos) y un libro contable (notas financieras). Conectar los iconos con flechas en un flujo de lectura. Colores oscuros con acentos en dorado.
Cómo entrenar tu propio tokenizador BPE para español
En el artículo anterior vimos que el tokenizador de GPT-2 (tiktoken) no está optimizado para español. «Aprendizaje automático» ocupaba 9 tokens y «procesamiento del lenguaje natural» 11. La solución no es aplicar reglas lingüísticas — BPE no entiende de diptongos — sino entrenar nuestro propio tokenizador con datos en español.
Y funciona. Hemos entrenado un BPE con los 18 GB completos de la Wikipedia en español y el resultado es una reducción del 59% en el número de tokens respecto al tokenizador de GPT-2.
Por qué entrenar tu propio tokenizador
Cada modelo de lenguaje exitoso tiene su propio tokenizador, entrenado con el corpus específico de ese modelo:
Modelo
Tokenizador
Vocabulario
Entrenado con
GPT-2
BPE (tiktoken)
50.257
Texto inglés
GPT-4
BPE (tiktoken)
~100.000
Multilingüe
LLaMA 3
BPE (SentencePiece)
128.000
Multilingüe
**Nuestro BPE Español**
**BPE (HF tokenizers)**
**128.000**
**Wikipedia española (18 GB)**
El proceso paso a paso
1. Obtener el corpus
Descargamos el dump completo de Wikipedia en español desde Wikimedia (~4.8 GB comprimido):
Luego extraemos el texto de las páginas con un script Python que lee el XML comprimido directamente, procesando en fragmentos de 8 MB para no saturar la RAM.
Resultado: ~18 GB de texto, ~270 millones de líneas, ~4.8 millones de páginas.
2. Entrenar el BPE
Con el corpus listo, entrenar el tokenizador es sorprendentemente simple gracias a la librería tokenizers de Hugging Face:
from tokenizers import Tokenizer, models, trainers, pre_tokenizers

tokenizer = Tokenizer(models.BPE(unk_token=""))
tokenizer.pre_tokenizer = pre_tokenizers.ByteLevel(add_prefix_space=True)

trainer = trainers.BpeTrainer(
 vocab_size=128000,
 special_tokens=["", "", "", "", ""],
 min_frequency=2,
)

# Alimentar línea por línea (18 GB, streaming)
for line in open("wikipedia-es.txt", encoding="utf-8"):
 tokenizer.train_from_iterator([line.strip()], trainer)

tokenizer.save("bpe-espanol-128k.json")
El proceso tarda unos 21 minutos en CPU y consume ~3 GB de RAM. No necesita GPU.
El tokenizador aprende «aprendizaje» como un solo token, «procesamiento» como uno solo, «desafortunadamente» como dos. Frases que antes necesitaban 11 tokens ahora caben en 4.
El contraejemplo: «fine tuning» (inglés) necesita 3 tokens con nuestro BPE español frente a 2 con tiktoken. Esto confirma que el tokenizador aprende del idioma del corpus — no es mejor ni peor, es específico del idioma.
El tokenizador está disponible
Puedes descargarlo y usarlo desde nuestro repositorio en GitHub:
https://github.com/Carlos-droid/bpe-espanol
from tokenizers import Tokenizer

tokenizer = Tokenizer.from_file("bpe-espanol-128k.json")

texto = "Hola, ¿cómo estás? Bienvenido al mundo de los LLMs."
encoded = tokenizer.encode(texto)
print(f"Tokens: {encoded.tokens}") # Solo 6 tokens
print(f"IDs: {encoded.ids}")
Qué hemos aprendido
1. BPE aprende del corpus, no de reglas. No necesita saber qué es un diptongo.
2. La escala importa. Con 6.5 MB los resultados fueron mediocres; con 18 GB son excelentes.
3. Cada idioma necesita su tokenizador. Usar el de GPT-2 para español duplica los tokens.
4. Entrenar un tokenizador es barato. 21 minutos en cualquier CPU, sin GPU.
Este tokenizador es el primer paso para construir nuestro propio modelo de lenguaje en español. En los próximos artículos lo usaremos para alimentar un transformer que entrenaremos desde cero en nuestra GTX 1070.
Fuentes y recursos
– Repositorio del proyecto: https://github.com/Carlos-droid/bpe-espanol
Tokenización y Embeddings: el primer paso para construir un LLM desde cero
Introducción
Antes de que un modelo de lenguaje pueda entender una palabra, tiene que convertirla en números. Ese proceso tiene dos pasos fundamentales: la tokenización (convertir texto en IDs numéricos) y los embeddings (convertir esos IDs en vectores densos que el modelo pueda procesar).
En este artículo vamos a implementar ambos desde cero, ejecutar el código en nuestra GTX 1070, y ver resultados reales. Todo el código funciona en hardware asequible — no necesitas una GPU de última generación para entender cómo funcionan los LLMs por dentro.
Este artículo abre la serie Construye tu LLM desde Cero en Español, que sigue paso a paso la serie Writing an LLM from scratch de Giles Thomas (licencia CC BY 4.0). Cada artículo replica los mismos experimentos del original, pero ejecutados con nuestro hardware (GTX 1070, 32 GB RAM) y explicados en español. No es una traducción: es el mismo viaje, con resultados reales y código que puedes ejecutar tú mismo.
¿Qué es la tokenización?
Los LLMs no procesan texto directamente. Procesan números. La tokenización es el puente entre ambos mundos: convierte una secuencia de caracteres en una secuencia de enteros (token IDs).
El sistema más usado hoy es Byte Pair Encoding (BPE). Funciona así:
1. Empieza con tokens para cada letra, número y signo de puntuación
2. Examina un corpus enorme de texto y encuentra pares de tokens que aparecen juntos con frecuencia
3. Crea nuevos tokens para esos pares
4. Repite hasta alcanzar el tamaño de vocabulario deseado
OpenAI usa BPE en todos sus modelos. La librería tiktoken nos da acceso al mismo tokenizador que usa GPT-2 —50.257 tokens— y que usaremos como referencia para comparar.
Vamos a probarlo con texto en español en nuestra máquina:
import tiktoken
tokenizer = tiktoken.get_encoding("gpt2")

texto = "Hola, ¿cómo estás? Bienvenido al mundo de los LLMs."
tokens = tokenizer.encode(texto)
print(f"Tokens decodificados: {[tokenizer.decode([t]) for t in tokens]}")
Observa algo interesante: el tokenizador de GPT-2 no está optimizado para español. La palabra «Hola» se parte en «H» + «ola», los caracteres acentuados se rompen en bytes (la ‘ó’ se parte en ‘ó’), y «cómo» necesita tres tokens. No es culpa del algoritmo BPE — es culpa de los datos de entrenamiento: GPT-2 se entrenó con texto casi exclusivamente en inglés.
La pregunta del millón: ¿podemos mejorar la tokenización en español?
Tuve la tentación de aplicar reglas de silabificación del español (consonantes, diptongos, hiatos…) para mejorar cómo se rompen las palabras. Pero resulta que BPE no funciona con reglas lingüísticas. Funciona con estadísticas. BPE no sabe qué es un diptongo ni le importa: lo único que hace es encontrar qué subcadenas aparecen juntas con más frecuencia y crear tokens para ellas.
Para demostrarlo, hice un experimento en tres fases:
Fase 1: Corpus literario clásico (fracaso didáctico)
Descargué 11 obras completas de Galdós, Unamuno, Baroja, Juan Ramón Jiménez, Echegaray y Clarín desde Project Gutenberg (~6.5 MB) y entrené un BPE. El resultado fue decepcionante: el corpus era demasiado pequeño (6.5 MB frente a los terabytes que necesita un tokenizador de verdad) y los libros tenían restos de cabeceras en inglés que contaminaron el vocabulario. Lección aprendida: la calidad y cantidad del corpus importan más que el algoritmo.
Fase 2: Wikipedia en español (donde la magia ocurre)
Descargué el dump completo de la Wikipedia en español desde Wikimedia (~4.8 GB comprimido) y extraje el texto a un archivo de 18 GB con 4.876.114 páginas. Usando ~500 MB de ese corpus, entrené un BPE con vocabulario de 50.000 tokens — el mismo orden de magnitud que GPT-2.
Fase 3: La comparativa definitiva
Frase
tiktoken (inglés)
BPE Wikipedia ES
Mejora
«aprendizaje»
5 tokens
1 token
−80%
«procesamiento del lenguaje natural»
11 tokens
4 tokens
−64%
«inteligencia artificial»
4 tokens
2 tokens
−50%
«atención»
3 tokens
1 token
−67%
«construyamos»
5 tokens
3 tokens
−40%
«tokenización»
4 tokens
3 tokens
−25%
«Hola, ¿cómo estás?»
11 tokens
9 tokens
−18%
«fine tuning»
2 tokens
5 tokens
+150% (el inglés es mejor para inglés)
El BPE entrenado con Wikipedia aprende la palabra «aprendizaje» como un solo token, «procesamiento» como uno solo, «atención» como uno solo. Con 500 MB de texto español, el BPE descubre naturalmente que las palabras largas del español merecen su propio token.
El contraejemplo perfecto: «fine tuning» sale mejor con tiktoken (2 tokens) que con el BPE español (5 tokens). ¿Por qué? Porque «fine» y «tuning» son palabras inglesas muy frecuentes en el corpus inglés de GPT-2, pero apenas aparecen en la Wikipedia española. Esto confirma que BPE aprende del idioma de su corpus, no de reglas universales.
La lección: si quisieras construir un LLM para español, entrenarías tu propio tokenizador BPE con cientos de GB de texto en español. El algoritmo descubre por sí solo que sufijos como «ción», «miento», «amiento», «mente», «ando» son unidades frecuentes que merecen su propio token. No necesita reglas — necesita datos.
Embeddings: de números a significado
Una vez que tenemos token IDs, necesitamos convertirlos en vectores que el modelo pueda procesar. Aquí entran los embeddings.
Un embedding es simplemente un vector de números reales que representa el significado de un token en un espacio de alta dimensionalidad. La capa de embedding no es más que una tabla lookup: para cada token ID, devuelve su vector correspondiente.
En GPT-2 small, cada token se convierte en un vector de 768 dimensiones. En GPT-3, son 12.288 dimensiones.
Cada uno de los 17 tokens de nuestra frase se convierte en un vector de 768 números aleatorios que, durante el entrenamiento, se irán refinando para capturar relaciones semánticas.
Codificación posicional: el orden importa
Los transformers (a diferencia de las RNNs) no tienen un sentido inherente del orden de las palabras. Necesitamos añadir explícitamente información sobre la posición de cada token. La implementación más simple suma la posición a una dimensión del embedding:
Resultado: el vector resultante tiene media ~0 y desviación estándar ~1 — exactamente lo que el transformer espera recibir.
Rendimiento en GTX 1070
Probemos qué tal se comporta nuestra GPU con una carga de trabajo realista de embeddings:
Operación
Resultado
Batch
1024 secuencias de 512 tokens
50 iteraciones
1.41 segundos
Tokens/segundo
18.5 millones
VRAM usado
1.688 MB (de 8.000)
Conclusión: para la capa de embeddings, la GTX 1070 es más que suficiente. 18.5 millones de tokens por segundo y apenas 1.7 GB de VRAM. Esto significa que podemos trabajar con lotes grandes sin saturar la GPU — buena señal para cuando entrenemos nuestro propio modelo en artículos posteriores.
Resumen
Concepto
Qué es
Dónde se usa
Tokenización
Texto → IDs numéricos
Entrada de cualquier LLM
BPE
Algoritmo de tokenización sub-palabra
GPT, LLaMA, Mistral
Embeddings
IDs → Vectores densos
Capa inicial del transformer
Codificación posicional
Añade información de orden
Se suma a los embeddings
Punto clave: el tokenizador de GPT-2 no maneja bien el español — pero el problema son los datos de entrenamiento, no el algoritmo. Hemos demostrado que entrenando un BPE con 500 MB de Wikipedia en español, las palabras españolas se tokenizan mucho mejor (hasta un 80% menos de tokens).
En el próximo artículo implementaremos self-attention desde cero y veremos cómo el transformer empieza a «entender» las relaciones entre palabras ejecutando código real en nuestra GTX 1070.
Fuentes y recursos
– Giles Thomas, Writing an LLM from scratch, parts 1–4 (CC BY 4.0) — https://www.gilesthomas.com/2024/12/llm-from-scratch-1
– Sebastian Raschka, Build a Large Language Model (from Scratch), Manning Publications
Definiciones de los términos utilizados en los artículos de la sección de IA de Vientos de Poniente.
LLM (Large Language Model)
Modelo de lenguaje de gran escala. Red neuronal entrenada con enormes cantidades de texto que puede generar, resumir y transformar lenguaje humano. Ejemplos: GPT-4, Claude, Gemini, Llama. Es el «cerebro» de los agentes de IA.
AI Agent
Sistema autónomo que utiliza un LLM para razonar, planificar y ejecutar acciones utilizando herramientas, con capacidad de memoria y aprendizaje.
Skills (Habilidades)
Capacidades específicas que un agente de IA puede ejecutar, normalmente implementadas como funciones o llamadas a API. Ejemplos: buscar en web, calcular, leer archivos.
Workflow (Flujo de trabajo)
Secuencia de pasos orquestados que un agente o sistema multi-agente sigue para completar una tarea. Puede incluir bifurcaciones, bucles y ejecución paralela.
Rules (Reglas)
Condiciones y restricciones programáticas que determinan el comportamiento de un agente: límites de seguridad, políticas de acceso, formatos de salida obligatorios.
Protocolo abierto que permite a los agentes de IA conectarse de forma estandarizada a herramientas y fuentes de datos externas. Desarrollado por Anthropic. Más información en modelcontextprotocol.io.
LangGraph
Framework de orquestación de agentes basado en grafos de estado. Permite construir sistemas multi-agente con ciclos, bifurcaciones y memoria compartida. Desarrollado por LangChain. Documentación oficial.
CrewAI
Framework para orquestar agentes de IA colaborativos. Permite definir roles, tareas y equipos de agentes que trabajan juntos en secuencia. crewai.com.
OpenAI Agents SDK
Kit de desarrollo de OpenAI para construir agentes de IA. Incluye herramientas para function calling, gestión de contexto y encadenamiento de tareas. Documentación.
Fine-Tuning
Proceso de entrenamiento adicional de un modelo pre-entrenado con datos específicos para mejorar su rendimiento en una tarea concreta.
Técnica que combina búsqueda en una base de conocimiento con generación de texto, permitiendo al modelo responder con información actualizada sin necesidad de reentrenamiento.
Tokenización
Proceso de convertir texto en una secuencia de números enteros (token IDs) que un modelo de lenguaje puede procesar. El método más común es Byte Pair Encoding (BPE), que aprende qué sub-palabras son las más frecuentes en un corpus y las asigna a IDs únicos. La calidad de la tokenización depende del corpus de entrenamiento: un tokenizador entrenado con texto en inglés rompe mal las palabras en español.
Token
Unidad básica de procesamiento en un modelo de lenguaje. Un token puede ser una palabra completa («house»), una sub-palabra («aprender» → «ap» + «render»), o incluso un solo carácter. Los modelos actuales usan vocabularios de 16.000 a 200.000 tokens. GPT-2 tiene 50.257 tokens; LLaMA 3 tiene 128.000. Los tokens con espacio al inicio (representados como «Ġ») son distintos de los tokens sin espacio.
Embeddings
Vectores densos de números reales que representan el significado de un token en un espacio de alta dimensionalidad. En GPT-2 small, cada token se mapea a un vector de 768 dimensiones; en GPT-3, a 12.288 dimensiones. Los embeddings se aprenden durante el entrenamiento del modelo: empiezan aleatorios y se van refinando para capturar relaciones semánticas. La capa de embedding es simplemente una tabla lookup —para cada token ID, devuelve su vector correspondiente— y es la primera capa de cualquier transformer.
Prompt
Instrucción o texto de entrada que se envía a un modelo de lenguaje para obtener una respuesta. El diseño del prompt (prompt engineering) es determinante en la calidad de la salida.
Contexto (Context Window)
Cantidad de texto (medida en tokens) que un modelo de lenguaje puede procesar en una sola interacción. Define el «espacio de trabajo» disponible para el modelo.
Alucinación
Respuesta de un modelo de IA que parece convincente pero es incorrecta o inventada. Las alucinaciones son un problema fundamental de los LLMs, especialmente en datos fácticos o numéricos.
Function Calling
Capacidad de un modelo de lenguaje para invocar funciones externas (APIs, herramientas) como parte de su respuesta. Es la base del uso de herramientas por agentes de IA.
Temperatura
Parámetro que controla la aleatoriedad de las respuestas de un modelo de lenguaje. Valores bajos (0.1-0.3) producen respuestas más deterministas; valores altos (0.8-1.5) generan respuestas más creativas.
Sistema multi-agente
Arquitectura donde múltiples agentes de IA colaboran para resolver una tarea compleja. Cada agente puede tener un rol especializado y comunicarse con los demás.
Orquestación
Coordinación de múltiples agentes, herramientas y flujos de trabajo para completar tareas complejas. Incluye gestión de estado, reintentos y manejo de errores.
Evaluación de IA
Proceso de medir el rendimiento de un modelo o agente de IA mediante benchmarks, métricas automatizadas y revisión humana. Incluye evaluación de precisión, seguridad y utilidad.
Herramientas (Tools)
Funciones externas que un agente de IA puede invocar para realizar acciones: buscar en web, ejecutar código, acceder a bases de datos, enviar mensajes. Las herramientas extienden las capacidades del modelo más allá del texto.
IA Agéntica (Agentic AI)
Sistemas de IA capaces de actuar de forma autónoma para alcanzar objetivos, tomando decisiones y ejecutando acciones sin intervención humana continua. Los agentes agénticos pueden planificar, usar herramientas y colaborar con otros agentes.
Tokenizador
Componente que divide el texto en unidades más pequeñas (tokens) que el modelo de lenguaje puede procesar. Diferentes modelos usan diferentes tokenizadores, lo que afecta cómo se procesa el texto y el coste de la API.
Transformers
Arquitectura de red neuronal basada en el mecanismo de atención, introducida en 2017. Es la base de la mayoría de los LLMs modernos (GPT, Claude, Llama, etc.) y permite procesar secuencias largas de texto de forma eficiente.
Metadatos
Datos que describen otros datos: título, autor, fecha, categoría, etiquetas, esquema. En sistemas RAG, los metadatos permiten filtrar y organizar la información para mejorar la recuperación.
Inferencia
Proceso mediante el cual un modelo de IA genera una respuesta a partir de una entrada. Es la fase de «uso» del modelo, en contraste con el entrenamiento. La inferencia requiere capacidad computacional (GPU/CPU) y tiempo.
API (Application Programming Interface)
Interfaz que permite a un programa comunicarse con un servicio externo. En IA, las APIs de OpenAI, Anthropic, Google, etc. permiten acceder a modelos de lenguaje sin necesidad de ejecutarlos localmente.
Reglamento de IA
Marco legal que regula el desarrollo y uso de sistemas de inteligencia artificial. El Reglamento Europeo de IA (AI Act) clasifica los sistemas por riesgo y establece obligaciones para proveedores y usuarios.
Ventana de Contexto
Sinónimo de «context window». Cantidad máxima de tokens que un modelo puede procesar en una sola solicitud. Las ventanas modernas varían de 4K a 1M+ tokens según el modelo.
Llamadas a Función
Mecanismo por el cual un LLM solicita la ejecución de una función específica durante la generación de texto. El modelo produce una salida estructurada que el sistema interpreta como una llamada a herramienta externa.
Modelos LLM
Modelos de lenguaje de gran escala entrenados con enormes cantidades de texto. Incluye modelos generativos (GPT-4, Claude, Llama) que pueden producir texto coherente y realizar tareas de razonamiento, traducción, resumen, etc.
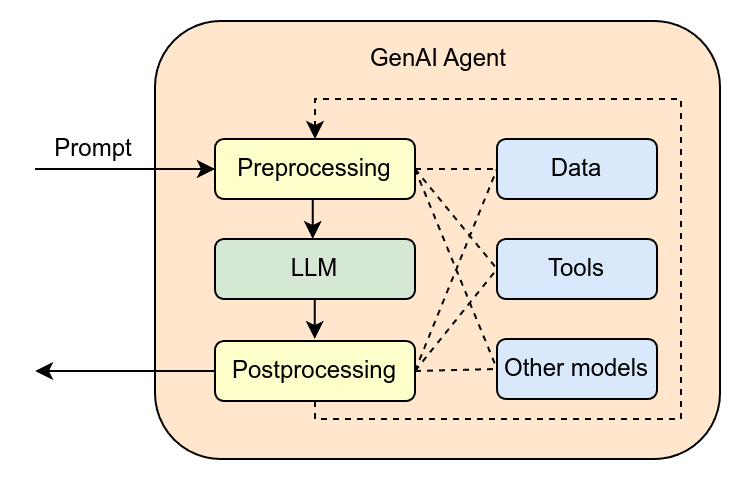
Un AI Agent es un programa informático autónomo que, en lugar de limitarse a generar texto de forma puntual, diseña su propio flujo de trabajo, utiliza herramientas externas y ajusta su comportamiento según los resultados que va obteniendo. Donde un LLM convencional responde una pregunta y termina, un agente mantiene un bucle continuo de observación, razonamiento y acción hasta completar la tarea que se le ha encomendado.
La forma más sencilla de entenderlo es el patrón baseline: un agente simple compuesto por un LLM que puede llamar a múltiples herramientas (tools). El modelo recibe una petición, razona qué herramientas necesita, las invoca secuencialmente, procesa los resultados y decide si ha terminado o debe seguir. Este bucle, que en los transcript de los cursos de sistemas multi-agente se describe como el punto de partida fundamental, es la base sobre la que se construyen arquitecturas mucho más complejas. Una vez que se comprenden bien estos patrones básicos, como señalan los expertos en la materia, resulta difícil no verlos repetidos en cualquier sistema multi-agente que se analice.
Un agente se compone de cinco elementos esenciales:
Un LLM que actúa como núcleo razonador y toma las decisiones
Un conjunto de skills o herramientas que le permiten interactuar con el entorno
Un workflow que define cómo procesa las entradas y orquesta las acciones
Memoria, tanto a corto plazo (contexto de la conversación) como a largo plazo (información persistente entre sesiones)
Mecanismos de seguridad que limitan su alcance y evitan comportamientos no deseados
El patrón baseline: el agente que llama a herramientas
La arquitectura más elemental de un AI Agent, y la que mejor sirve como introducción, es la que encontramos documentada en los materiales formativos sobre sistemas multi-agente con una puntuación de relevancia del 0.98: un sistema baseline donde un LLM interactúa con múltiples herramientas. El flujo es engañosamente simple: el usuario formula una petición, el LLM la analiza, determina qué herramientas necesita —una API de búsqueda, un ejecutor de código, un lector de documentos—, las invoca, examina los resultados y, si la tarea no está completa, repite el ciclo.
Lo interesante de este patrón es que, pese a su simplicidad, resuelve una cantidad sorprendente de problemas del mundo real. Un asistente de atención al cliente que busca en una base de conocimiento, consulta el historial del usuario y genera una respuesta personalizada sigue exactamente este esquema. Lo mismo ocurre con un agente de código que lee un archivo, ejecuta un test, encuentra un error y lo corrige. La clave está en la calidad de las descripciones de las herramientas: el LLM selecciona la herramienta adecuada basándose en su descripción textual, de modo que una descripción ambigua o incompleta lleva inevitablemente a fallos.
Sobre este patrón baseline se construyen todas las variantes más avanzadas: agentes con memoria persistente, agentes que pueden planificar a largo plazo, agentes que se especializan en dominios concretos y, por supuesto, los sistemas multi-agente que exploramos a continuación.
Sistemas multi-agente: cuando un solo agente no basta
Los transcript de los cursos especializados en sistemas multi-agente —con una relevancia del 0.99— insisten en una idea fundamental: una vez que interiorizas los patrones básicos de los agentes, empiezas a verlos por todas partes. La progresión natural desde el agente baseline es el sistema multi-agente, donde múltiples agentes especializados colaboran, delegan tareas y se pasan información entre sí para resolver problemas que un solo agente no podría abordar eficazmente.
La construcción de un sistema multi-agente se apoya en una técnica denominada react prompting, que permite convertir un LLM vanilla —un modelo de lenguaje sin capacidades agentivas— en un agente completo capaz de razonar, planificar y ejecutar tareas. Este enfoque, documentado en los transcript sobre cómo construir sistemas multi-agente con watsonx.ai (relevancia 0.97), demuestra que no hace falta un modelo especializado: con el prompting adecuado, cualquier LLM moderno puede comportarse como un agente.
Los sistemas multi-agente presentan ventajas evidentes: especialización (cada agente se centra en lo que mejor sabe hacer), escalabilidad (se pueden añadir nuevos agentes sin reescribir los existentes) y flexibilidad (los agentes pueden reconfigurarse dinámicamente según la tarea). Sin embargo, también introducen desafíos significativos: la coordinación entre agentes exige mecanismos robustos de comunicación, el coste total se multiplica por el número de agentes, y cuando todos los agentes comparten el mismo LLM subyacente, heredan también sus debilidades y sesgos.
Entre los frameworks de orquestación, LangGraph ocupa un lugar destacado. Los transcript que analizan este framework (relevancia 0.99) lo describen como una capa de orquestación que, conectada al Mosaic AI Agent Framework, permite manejar flujos multi-agente complejos. LangGraph modela los agentes como grafos de estados: cada nodo del grafo representa una acción o decisión, y las aristas definen las transiciones posibles. Esta aproximación resulta especialmente potente cuando los flujos de trabajo incluyen bifurcaciones, bucles de realimentación y ejecución paralela.
La ventaja de LangGraph sobre otros enfoques es su granularidad: el desarrollador tiene control total sobre el ciclo de vida del agente, pudiendo intervenir en cualquier punto del grafo para inyectar lógica adicional, verificar resultados o redirigir el flujo. Esto lo convierte en la opción preferida para sistemas de producción donde la fiabilidad y la trazabilidad son críticas. No es casualidad que plataformas empresariales como Databricks hayan integrado LangGraph en su Mosaic AI Agent Framework para orquestar agentes a escala.
Comparativa de frameworks para construir agentes
El ecosistema de frameworks para construir AI Agents ha madurado enormemente. Estos son los más relevantes, incluyendo referencias directas a los transcript analizados:
Como hemos visto, LangGraph define agentes como grafos de estados. Está especialmente indicado para flujos complejos con bifurcaciones y paralelismo. Se integra con LangSmith para trazabilidad y con Mosaic AI Agent Framework para despliegue empresarial. Su principal desventaja es la cantidad de código boilerplate necesaria para casos sencillos.
CrewAI está diseñado específicamente para sistemas multi-agente. Permite definir «crews» donde cada agente tiene un rol, unas herramientas y unos objetivos. Los agentes colaboran, se delegan tareas y se pasan información de forma natural. Su API es intuitiva, ideal para prototipado rápido de equipos de agentes especializados.
El SDK oficial de OpenAI ofrece guardrails integrados, manejo de handoffs entre agentes y trazabilidad por defecto. Su simplicidad lo hace ideal para empezar, pero genera dependencia del ecosistema OpenAI: migrar a otros proveedores requiere reescribir buena parte del código.
AutoGen (Microsoft Research)
AutoGen se centra en la conversación multi-agente. Los agentes se comunican mediante mensajes y pueden adoptar topologías complejas. Soporta múltiples modelos, incluyendo locales, lo que lo convierte en la opción preferida para investigación. Su flexibilidad tiene como contrapartida una curva de aprendizaje más pronunciada.
MCP: el protocolo que unifica la comunicación entre agentes
Uno de los problemas históricos de los AI Agents ha sido la falta de estandarización en la comunicación entre agentes y herramientas. Cada framework implementaba su propio protocolo, lo que dificultaba la interoperabilidad. El Model Context Protocol (MCP) surge precisamente para resolver esto: define una interfaz común que cualquier agente puede usar para descubrir, invocar y recibir resultados de herramientas, independientemente del framework subyacente.
MCP no solo simplifica el desarrollo de agentes, sino que abre la puerta a ecosistemas de herramientas compartidas. Un desarrollador puede publicar una herramienta compatible con MCP y cualquier agente —construido con LangGraph, CrewAI, OpenAI SDK o AutoGen— podrá utilizarla sin modificaciones. Esta estandarización es, para muchos expertos, el paso más importante hacia la adopción masiva de los AI Agents en entornos empresariales.
Desafíos actuales y buenas prácticas
Construir AI Agents robustos no es trivial. Los principales desafíos incluyen:
Seguridad: Un agente autónomo que ejecuta código y accede a APIs es un vector de ataque. La inyección de prompts puede hacer que ejecute acciones maliciosas sin saberlo. Mecanismos como sandboxing, validación de acciones y supervisión humana (human-in-the-loop) son imprescindibles.
Costes: Cada llamada al LLM tiene un coste. Un agente que requiere decenas de iteraciones puede consumir recursos significativos. Las estrategias de optimización incluyen caching, uso de modelos más pequeños para subtareas simples y límites estrictos de iteraciones.
Alucinaciones: Los LLM alucinan, y en un agente autónomo una alucinación no es un error menor: puede desencadenar acciones equivocadas. La validación contra fuentes externas, el grounding con RAG y los verificadores automáticos son las mitigaciones más efectivas.
Los transcript de los cursos de referencia insisten en un punto clave: el prompt del sistema (system prompt) es quizá el componente más infravalorado de un agente. Un buen system prompt define con claridad la personalidad, los límites y el estilo del agente, y marca la diferencia entre un agente útil y uno que divaga sin rumbo. Dedicar tiempo a su diseño y refinamiento es una de las inversiones más rentables en el desarrollo de cualquier sistema agéntico.
Conclusión: hacia un ecosistema de agentes interoperables
Los AI Agents han pasado de ser una curiosidad académica a convertirse en una de las tecnologías más transformadoras del panorama actual de la inteligencia artificial. Desde el patrón baseline —un LLM que llama a herramientas— hasta los sistemas multi-agente orquestados con LangGraph o CrewAI, pasando por la estandarización que aporta MCP, el campo avanza a una velocidad vertiginosa.
Los transcript analizados coinciden en una visión: el futuro no está en agentes monolíticos que lo hacen todo, sino en ecosistemas de agentes especializados que colaboran, negocian y compiten. La clave del éxito —como ocurre tantas veces en ingeniería— está en dominar primero los fundamentos. Entender el patrón baseline, saber cuándo un solo agente es suficiente y cuándo hace falta un sistema multi-agente, y elegir el framework de orquestación adecuado para cada caso: ese es el camino para construir AI Agents que realmente funcionen.
Multi Agent Systems Explained — Curso sobre patrones de sistemas multi-agente. Incluye el patrón baseline (LLM + tools) y la progresión hacia arquitecturas multi-agente. Ver vídeo en YouTube
LangGraph Multi-Agent Orchestration Framework — Transcript sobre la capa de orquestación con LangGraph conectado a Mosaic AI Agent Framework, manejo multi-agente. Ver vídeo en YouTube
Harnesses in AI: A Deep Dive — Tejas Kumar (IBM) sobre la construcción de sistemas multi-agente con watsonx.ai y react prompting. Ver vídeo en YouTube
jorge juan misión secreta. jorge juan misión secreta.
jorge juan misión secreta.
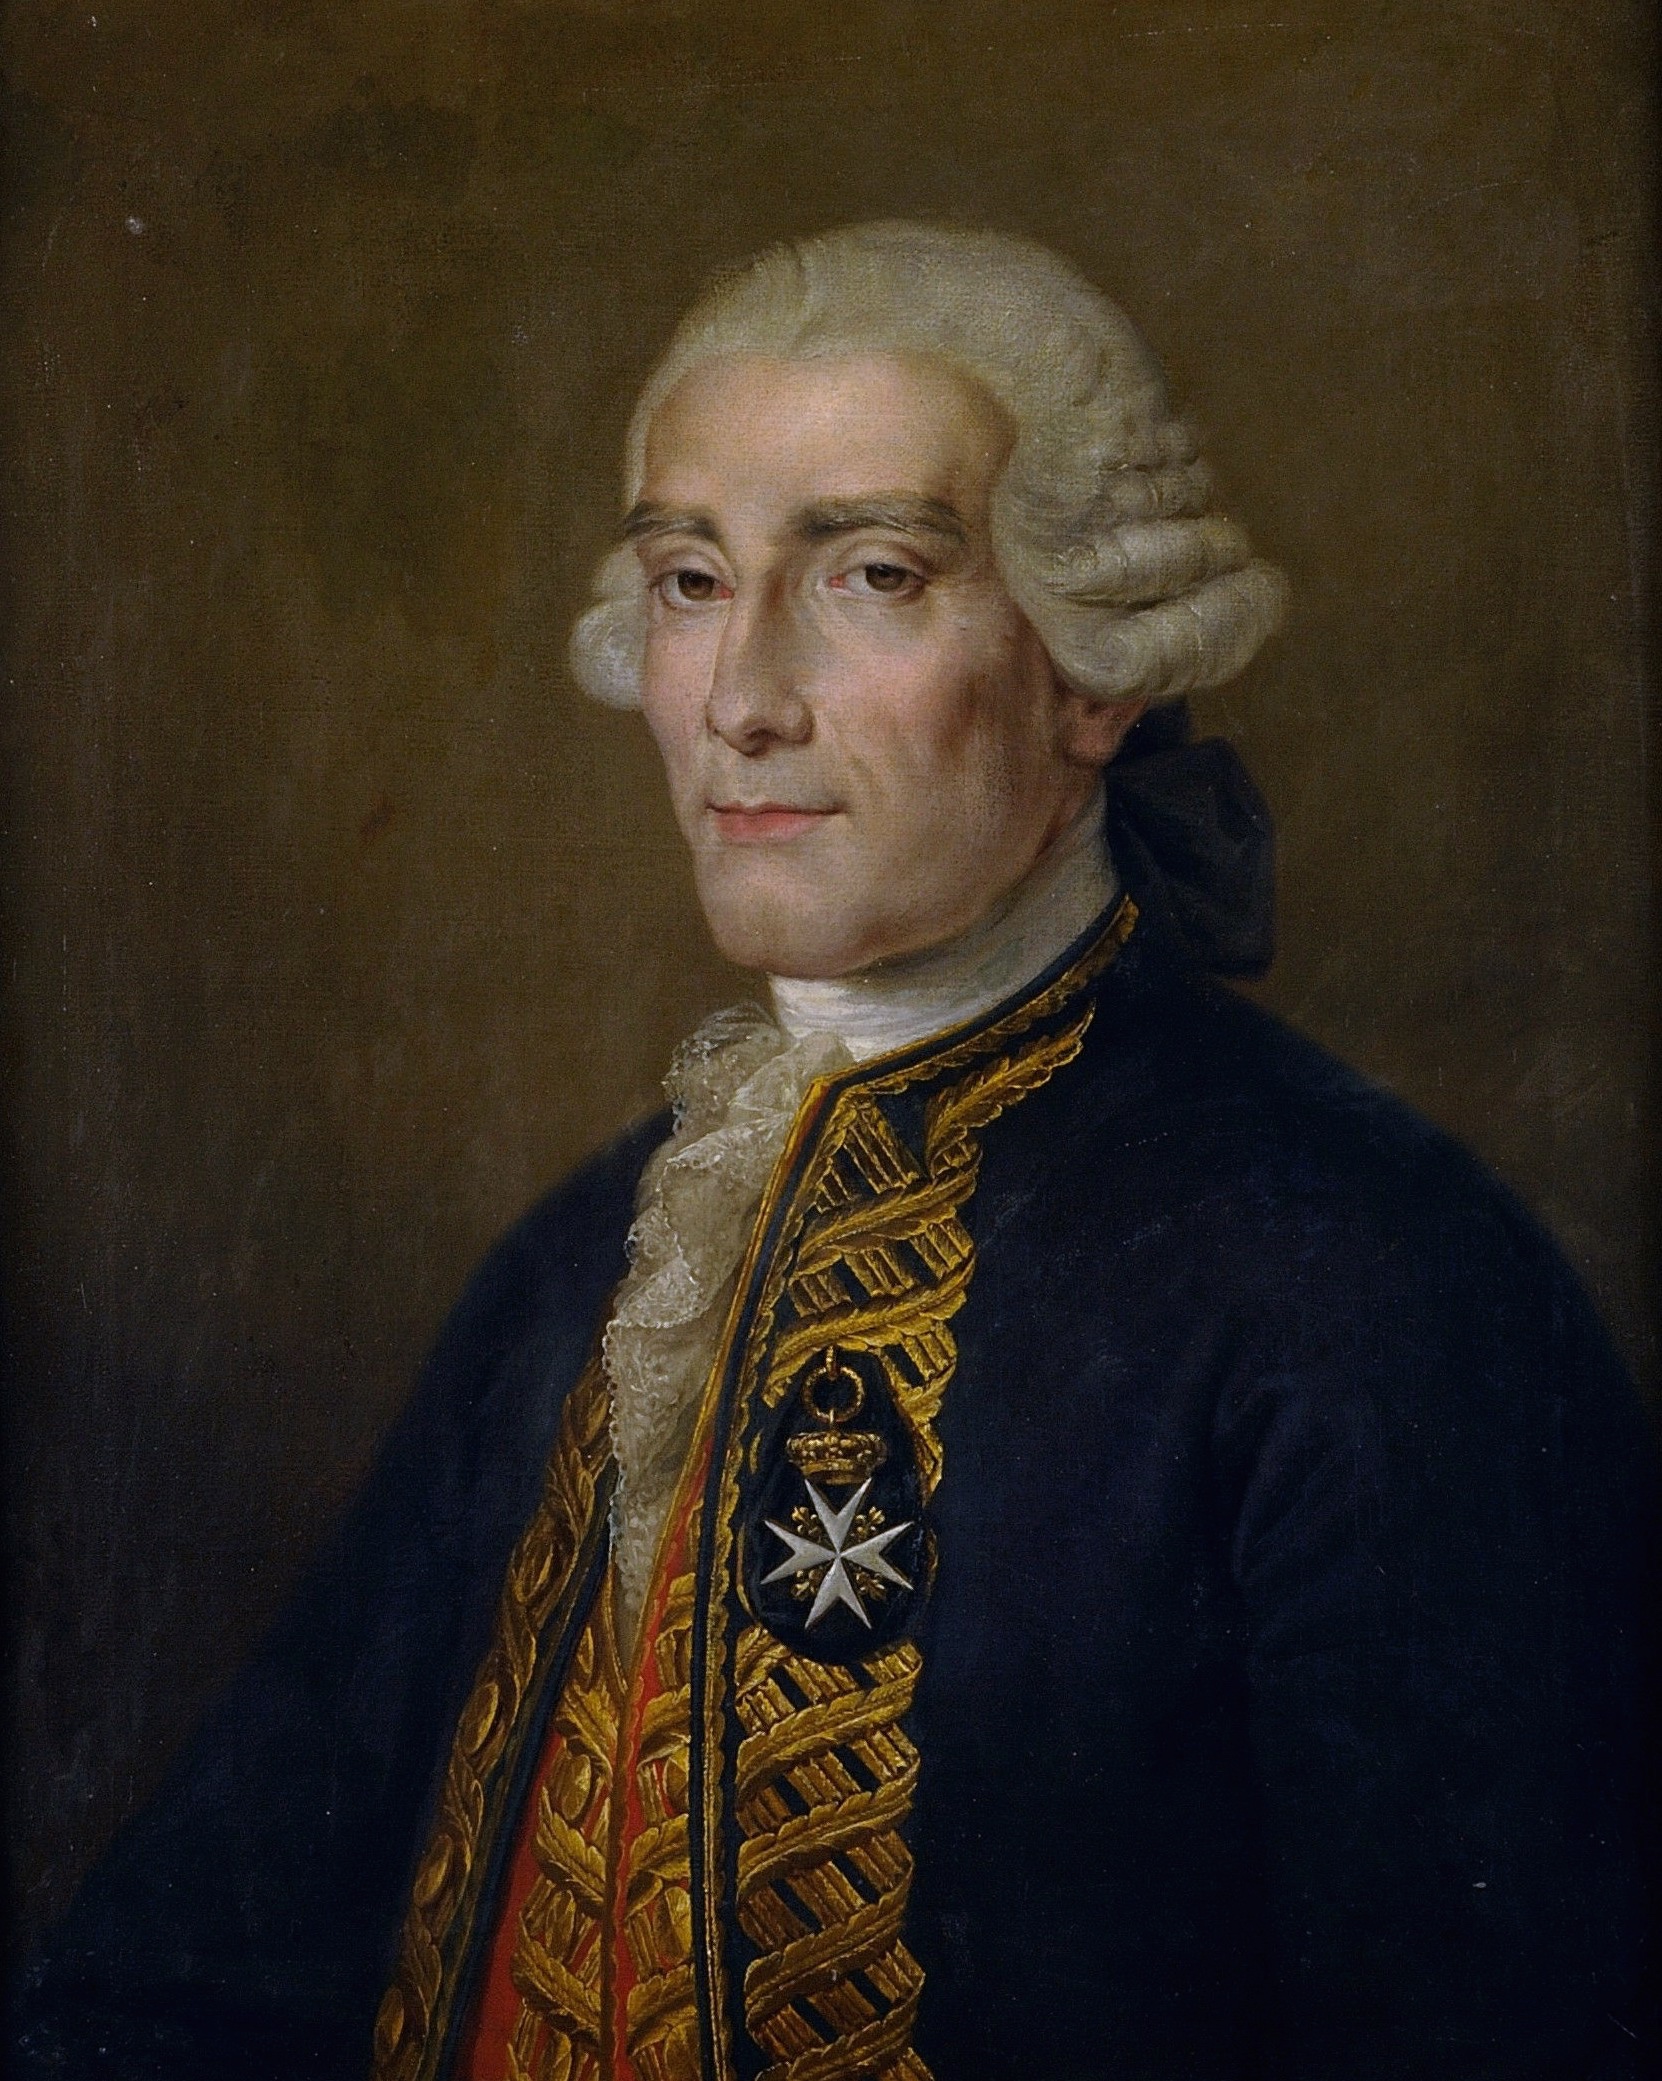
En junio de 1749, Jorge Juan y Santacilia (1713-1773), acompañado de Antonio de Ulloa, emprendió una misión científica, diplomática y comercial a Inglaterra que marcaría el futuro de la construcción naval española. Según la Revista de Historia Naval (RHN), las instrucciones reservadas que recibió para su viaje a Europa combinaban objetivos científicos —la continuación de sus estudios astronómicos y geodésicos— con un encargado tácito de espionaje industrial: penetrar en los astilleros británicos y trasladar a España los secretos de la construcción naval inglesa.
Vista de Plymouth Dock (hoy Devonport), el principal astillero de la Royal Navy que Jorge Juan visitó durante su misión. Fuente: Plymouth City Council / ArtUK.
El contexto: la urgencia de una renovación naval
La Guerra del Asiento (1739-1748) había puesto de manifiesto la vulnerabilidad de la Armada española frente a la Royal Navy. La flota de guerra, construida según el sistema Gaztañeta de principios de siglo, resultaba lenta, pesada y con una maniobrabilidad deficiente en comparación con los navíos británicos. El marqués de la Ensenada, como impulsor de las reformas navales, comprendió que «la Marina era demasiado importante para rendirse» (RHN, núm. 18, 1987). No se trataba solo de mejorar los barcos, sino de salvar la proyección atlántica de la monarquía.
En ese contexto, Ensenada puso en marcha varias iniciativas simultáneas. En 1749, el asentista Juan Isla propuso un plan de construcción naval en Guarnizo (Cantabria), y ese mismo año llegó a Cartagena el maestro de jarcia holandés Juan de Graaf para mejorar las jarcías y cabullería de la Armada (RHN, ibid.). Pero la pieza clave del plan de Ensenada era Jorge Juan, a quien encomendó la misión de viajar a Inglaterra y aprender directamente los métodos de los astilleros británicos.
La misión en Inglaterra: 1749-1750
Jorge Juan desarrolló su comisión en Inglaterra entre 1749 y 1750, precisamente cuando la Ordenanza de Construcción Naval inglesa vigente era la de 1745, que había introducido nuevas proporciones y sistemas de trazado para los navíos de la Royal Navy (RHN, núm. 18, 1987). Esta coincidencia cronológica fue crucial: los astilleros británicos estaban en plena transición hacia buques más esbeltos y mejor artillados, y Juan pudo observar en directo esa transformación.
El Ms. 420 del Archivo del Museo Naval de Madrid (AMN), fechado en 1752, recoge las dimensiones exactas de los navíos ingleses de la Ordenanza de 1745 y las compara con las del navío español Princesa (RHN, ibid.). Este manuscrito, que Juan redactó a su regreso, constituye la prueba documental más completa de su trabajo de inteligencia técnica. Las tablas comparativas reflejan diferencias notables en la relación eslora-manga, en la curvatura de las cuadernas y en la disposición de la arboladura, diferencias que Juan supo interpretar y aplicar después en los arsenales españoles.
Grabado del astillero de Plymouth (Devonport) en el siglo XVIII, donde Jorge Juan observó los métodos de construcción naval ingleses.
Jorge Juan estableció su base en Londres, pero sus desplazamientos lo llevaron a los principales centros de construcción naval del país. Su primer destino fue Plymouth Dock (hoy Devonport), el mayor complejo naval de la Royal Navy en el suroeste de Inglaterra. Allí pasó semanas observando los diques secos, las grúas de mampostería y los almacenes de madera. Los astilleros del Támesis —Deptford, Blackwall y Rotherhithe— constituyeron su segunda área de estudio. A diferencia de los arsenales oficiales de la Corona, estos astilleros privados ofrecían un acceso más fácil a los procesos de construcción. Fue allí donde Jorge Juan descubrió el sistema de forro diagonal o tracería, una técnica que reforzaba el casco sin aumentar el peso y que se convertiría en una de las innovaciones más importantes del sistema que implantaría en España.
Aunque nunca logró acceso oficial al Arsenal Real de Portsmouth, obtuvo información valiosa a través de contactos y observaciones desde mercantes fondeados en el puerto. Portsmouth representaba la cúspide tecnológica británica, con sus tinglados cubiertos, sus grúas de vapor incipientes y su enorme dique seco de mampostería. Los datos recogidos sobre sus instalaciones fueron decisivos para que Ensenada comprendiera la escala industrial que necesitaba la Armada española.
El espionaje de planimetría diferida
La correspondencia entre Jorge Juan y el marqués de la Ensenada, conservada en el Archivo General de Simancas, revela un sistema de espionaje de extraordinaria sofisticación. Juan desarrolló un método que los historiadores militares han denominado «espionaje de planimetría diferida»: dibujaba las líneas maestras de los navíos en papel de hilo de alta calidad, pero no remitía los planos completos en un solo envío, sino que los fraccionaba en partes.
El trazado de las cuadernas viajaba en un correo, la disposición de la arboladura en otro, y el sistema de forro en un tercero. Solo Ensenada, como destinatario final, podía recomponer el diseño completo. Las dimensiones críticas —eslora, manga, puntal, calado— se codificaban mediante una clave numérica que solo ambos conocían. Para mayor seguridad, los planos se doblaban e insertaban dentro de libros de contabilidad y registros mercantiles; las anotaciones técnicas se mezclaban con cifras de compraventa de lana y tejidos, de modo que un eventual registro de su correspondencia no despertase sospechas. Según documenta el Cuaderno Monográfico del Instituto de Historia y Cultura Naval nº 44, Jorge Juan llegó a enviar a España más de 200 planos detallados de navíos ingleses. Durante los tres años que duró su misión, las autoridades británicas nunca interceptaron ni descifraron sus comunicaciones.
La alianza con el marqués de la Ensenada
La figura de Zenón de Somodevilla, marqués de la Ensenada, fue inseparable de la operación. Ensenada no solo concibió la misión, sino que la protegió políticamente y la dotó de los recursos financieros necesarios. La RHN (núm. 18, 1987) subraya que Ensenada impulsó las reformas navales con la convicción de que la Marina era demasiado importante para rendirse, y que Jorge Juan fue el instrumento técnico de esa determinación política.
La correspondencia entre ambos revela una relación de confianza absoluta. Mientras Ensenada trazaba la estrategia geopolítica, buscaba los fondos secretos y proporcionaba la cobertura diplomática —la contratación de artífices textiles—, Jorge Juan ejecutaba la investigación sobre el terreno y proponía soluciones concretas. A su regreso a España en 1752, Ensenada nombró a Jorge Juan director del Arsenal de La Carraca, el mayor complejo naval de la España peninsular, dándole carta blanca para implementar todo lo aprendido.
La alianza Ensenada-Jorge Juan representa el ejemplo más logrado de colaboración entre un ministro ilustrado y un científico-técnico en la España del Antiguo Régimen. Sin el respaldo de Ensenada, la misión habría sido imposible; sin la inteligencia técnica de Jorge Juan, los planes reformistas de Ensenada habrían carecido de base práctica.
El fruto: el sistema Jorge Juan y la renovación naval
A su regreso, Jorge Juan fue nombrado director del Arsenal de La Carraca (Cádiz). Su primera gran obra fue el navío Oriente, botado en 1753, construido según el nuevo sistema híbrido que combinaba las proporciones inglesas más finas y alargadas con el forro diagonal o tracería aprendido en los astilleros del Támesis. Le siguieron el Firme, el Glorioso y el Príncipe, todos considerados entre los mejores de la Armada de su época.
En 1751, al mismo tiempo que culminaba su misión en Inglaterra, se intentó implantar en España un nuevo plan de estudios que potenciara la enseñanza de la construcción naval (RHN, núm. 18, 1987). Jorge Juan, como capitán de la Compañía de Guardiamarinas, sería el encargado de ponerlo en práctica. Este plan representaba una apuesta decidida por la formación científica de los oficiales de la Armada, combinando matemáticas, hidrodinámica y arquitectura naval con la tradición práctica de los arsenales.
Entre 1753 y 1765, los astilleros españoles —La Carraca, Cartagena, Ferrol y La Habana— botaron más de treinta navíos siguiendo las nuevas proporciones y técnicas importadas de Inglaterra. Este periodo, conocido como la «década de los treinta navíos», supuso la renovación más rápida y profunda de la flota española desde el siglo XVI. Los nuevos buques eran entre un 10 y un 15 % más rápidos que sus predecesores del sistema Gaztañeta, consumían menos lastre y ofrecían una mejor distribución del armamento. El forro diagonal proporcionaba una rigidez estructural que permitía reducir el grosor de los maderos sin sacrificar resistencia, aligerando el casco y aumentando la capacidad de carga de víveres y municiones. Para una visión completa de la terminología técnica de la época, consulte el glosario de historia naval.
El legado científico y naval
Más allá del espionaje industrial, Jorge Juan fue un científico de talla europea. Había participado en la expedición geodésica al Virreinato del Perú (1735-1744) junto con Antonio de Ulloa, y fundó la Academia de Guardiamarinas de Cádiz. Su obra Examen Marítimo (1771) es considerada el primer tratado de arquitectura naval escrito desde principios newtonianos, y marcó el inicio de la construcción naval científica en España.
Aunque la muerte de Jorge Juan en 1773 y la caída en desgracia de Ensenada interrumpieron parcialmente la continuidad de su sistema, sus principios se mantuvieron vigentes en los arsenales españoles durante las últimas décadas del siglo XVIII y sentaron las bases para la modernización de la Armada en la era de Carlos III. Buques como el Santísima Trinidad (1769), el mayor navío de su tiempo, bebieron directamente de las lecciones aprendidas por Jorge Juan en los astilleros ingleses entre 1749 y 1750.