Autor: admin

  • Prompt Engineering en producción

    Prompt Engineering en producción

    Prompt Engineering en producción

    Publicación: Viernes 19 de junio de 2026 · Campaña IA

    Relacionado: Prompt Engineering en producción

    Relacionado: Prompt Engineering en producción: guía práctica más allá del playground


    1. Fundamentos de la ingeniería de prompts

    La ingeniería de prompts es una disciplina relativamente nueva que se centra en diseñar entradas efectivas para modelos de lenguaje grandes (LLMs). El objetivo es obtener respuestas precisas con el mínimo número de tokens posible, reduciendo así costes operativos. En esencia, un prompt bien diseñado puede marcar la diferencia entre una respuesta genérica y una solución útil y accionable.

    Los LLMs son, en su núcleo, predictores estadísticos de la siguiente palabra (token). Entrenados con cantidades masivas de texto y la arquitectura Transformer, su mecanismo fundamental es sorprendentemente simple: dado un contexto, predecir qué token viene a continuación. Esta simplicidad escalada es lo que genera comportamientos aparentemente inteligentes.

    La intuición central que guía toda la ingeniería de prompts es tratar al LLM como un «humano mecánico tonto»: no es inteligente en el sentido humano, sino un emparejador de patrones mecánico. Rinde mejor con lenguaje familiar, se distrae con contexto excesivo, no puede inferir información que no esté en el prompt o en sus datos de entrenamiento, y fallará si el prompt en sí mismo resulta confuso para un humano.

    2. Técnicas fundamentales de prompting

    Few-shot prompting: Consiste en proporcionar al modelo varios ejemplos artesanales de la tarea deseada dentro del prompt. Al establecer un patrón predecible, el modelo se condiciona a continuar ese patrón y realizar la tarea (por ejemplo, ejemplos de traducción). Un hallazgo importante: los ejemplos pueden sesgar la respuesta, por lo que hay que seleccionarlos cuidadosamente.

    Chain-of-Thought (CoT): Para mejorar el razonamiento, especialmente en matemáticas y lógica, CoT pide al modelo que «piense paso a paso». Esto proporciona un «espacio de borrador» externo que reemplaza la falta de monólogo interno del modelo. La simplificación más potente es añadir «Pensemos paso a paso», que elimina la necesidad de ejemplos curados y reduce el sesgo.

    Document Mimicry (mimetismo de documentos): Es quizás la técnica más importante. Consiste en estructurar el prompt para que imite el formato de documentos que el modelo ha visto durante el entrenamiento (transcripciones, archivos markdown, código). Al usar encabezados familiares, roles y motivos (como markdown), el modelo predice mejor los siguientes tokens y produce salidas más relevantes y estructuradas.

    3. De la teoría a la producción

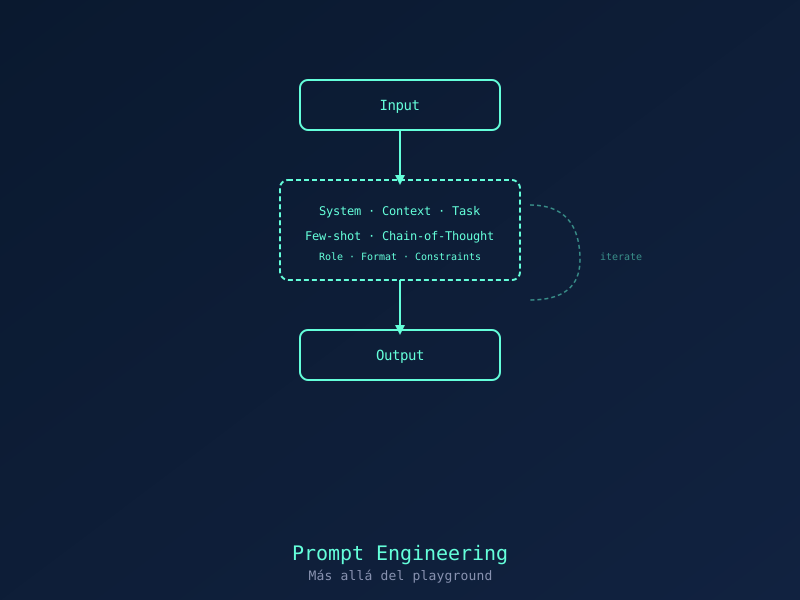
    Llevar la ingeniería de prompts a producción implica construir una capa de transformación entre el dominio del problema del usuario y el dominio del texto del LLM. La aplicación debe recopilar, clasificar, recortar y ensamblar el contexto (rutas de archivos, pestañas abiertas, documento actual) en un prompt estructurado, para luego transformar la respuesta del modelo en una acción útil para el usuario.

    Los parámetros del modelo son cruciales en producción. La temperatura controla la aleatoriedad de la salida (0.0 produce respuestas deterministas, 1.0 máxima creatividad). En producción, la temperatura baja (0.0–0.2) es preferible para tareas que requieren precisión. El top-p (nucleus sampling) y los penalty de frecuencia/presencia ayudan a evitar repeticiones y a diversificar el vocabulario.

    El coste es un factor determinante. Cada prompt cuesta dinero en función del consumo de tokens. Los desarrolladores deben escribir prompts concisos y válidos para obtener respuestas precisas minimizando costes. Esto es un principio central: la calidad del prompt afecta directamente a la calidad y al coste de la respuesta.

    4. El cambio a modelos conversacionales y function calling

    La transición a modelos basados en chat (como ChatGPT) introdujo una API estructurada con roles diferenciados (system, user, assistant). Este paradigma ofrece seguridad integrada, comportamiento controlado mediante mensajes del sistema y resistencia a la inyección de prompts, convirtiéndose en el marco dominante para construir aplicaciones con LLM.

    El function calling (llamada a funciones) permite a los LLM interactuar con APIs externas. Definiendo funciones con nombres, descripciones y parámetros claros, el modelo puede elegir llamar a una herramienta (como get_weather) en lugar de generar una respuesta textual. La aplicación ejecuta la función y devuelve el resultado al modelo, permitiendo al LLM actuar sobre datos del mundo real.

    Prakash Senapathi, en su taller de 157 minutos, enfatiza que la ingeniería de prompts es un dominio en evolución con alta demanda laboral. Muchas empresas contratan a recién titulados para roles de investigación, y la experiencia no siempre es un requisito. El campo ofrece buenas oportunidades de crecimiento, especialmente para quienes entran pronto.

    5. Mejores prácticas para producción

    Las mejores prácticas para prompt engineering en producción incluyen: usar el mensaje del sistema para establecer el comportamiento y las restricciones del modelo de forma consistente; iterar sobre los prompts midiendo el rendimiento con métricas objetivas; versionar los prompts como se versiona el código; implementar pruebas automatizadas que verifiquen que los cambios no introducen regresiones; y monitorizar el coste por token y la tasa de éxito.

    El «mimetismo de documentos» es particularmente útil en producción. Si el formato de entrada se asemeja a documentos que el modelo ya conoce (JSON estructurado, markdown con encabezados, transcriptos de diálogos), la calidad de la respuesta mejora significativamente sin necesidad de ejemplos adicionales.

    La lección final: no existe el prompt perfecto. La ingeniería de prompts es un proceso iterativo de refinamiento continuo, donde cada iteración revela nuevas aristas del comportamiento del modelo y nuevas oportunidades de optimización.


    Fuentes

    • Mr. Prakash Senapathi — «Prompt Engineering — Strategies For Success With AI» (YouTube). Duración: 157 min. URL: https://www.youtube.com/watch?v=2n-RIgSNnwQ
    • Prompt Engineering Workshop — «Hands-on Prompt Engineering» (YouTube). Duración: 62 min. URL: https://www.youtube.com/watch?v=htBTho6oEJA

    Atribución: Este artículo adapta material de las charlas de Prakash Senapathi y del Prompt Engineering Workshop.


    Sugerencia de imagen

    Diagrama que muestre la arquitectura de transformación: dominio del problema → capa de recopilación de contexto → ensamblaje de prompt → LLM → respuesta → acción útil. Estilo diagrama de flujo técnico con iconos, colores azul oscuro y dorado. Puede generarse como figura abstracta indicando «Generado por IA — representación conceptual».

    Ver también en el glosario: Function Calling, Temperatura, Prompt, Acción, Token
  • Evaluación de agentes: cómo medir lo no determinista

    Evaluación de agentes: cómo medir lo no determinista

    Evaluación de agentes: cómo medir lo no determinista

    Publicación: Viernes 12 de junio de 2026 · Campaña IA

    Relacionado: Agentes conversacionales robustos

    Relacionado: Evaluación de agentes: cómo medir lo no determinista


    1. El desafío de evaluar agentes

    Evaluar sistemas de agentes de IA es fundamentalmente distinto a evaluar software tradicional. Un agente es no determinista, no acotado y puede usar herramientas para afectar arbitrariamente a otros sistemas. Esto hace que las pruebas unitarias clásicas y los conjuntos de datos «dorados» sean insuficientes para capturar la larga cola de problemas que surgen en producción.

    Lori Voss, ex-cofundadora de npm Inc. y actual responsable de experiencia desarrollador en AriseAI, plantea el problema con claridad: los agentes pueden tomar caminos diferentes cada vez que ejecutan una misma tarea. Una misma instrucción puede generar secuencias de llamadas a herramientas completamente distintas según el estado del modelo, el orden de las operaciones o el contexto acumulado. Esto exige un enfoque de evaluación probabilística, no determinista.

    El cambio de paradigma es profundo: en lugar de verificar que un agente hace «lo correcto» siempre de la misma manera, debemos evaluar si el resultado final es correcto y si el agente fue eficiente y seguro en el proceso. Esto implica medir no solo la precisión de la salida, sino también la calidad de las decisiones intermedias.

    2. Métricas para la evaluación de agentes

    Las evaluaciones de agentes se estructuran en dos grandes categorías de señales: explícitas e implícitas. Las señales explícitas son métricas objetivas y verificables: tasa de error, latencia, coste por tarea, tasa de regeneración, tiempo medio de finalización. Estas son fáciles de medir y comparar, pero no capturan la calidad semántica del trabajo del agente.

    Las señales implícitas son más difíciles de detectar pero ofrecen información más valiosa. Incluyen patrones de regex, clasificadores binarios y autodiagnósticos. Las señales implícitas más efectivas no son valoraciones genéricas tipo «LLM-as-a-judge», sino clasificadores binarios específicos para problemas concretos: rechazos (el agente se niega a actuar), fallo de tarea, frustración del usuario, jailbreaking, brechas de capacidad.

    Nicholas Kang (Mozilla) introduce el concepto de evaluaciones agentic a escala: en lugar de depender de conjuntos de datos estáticos, propone usar entornos simulados (como Game Arena, OpenSpiel) donde los agentes compiten o colaboran, generando métricas de rendimiento relativo. Evalúa a los agentes no contra un estándar absoluto, sino contra otros agentes en condiciones comparables.

    3. Estrategias prácticas de evaluación

    Una técnica poderosa y de bajo esfuerzo son los autodiagnósticos: añadir una herramienta «report» al conjunto del agente e indicarle en el prompt del sistema que informe de incidencias a sus creadores. Esto permite detectar brechas de capacidad, fallos de herramientas y atajos no deseados (por ejemplo, un agente que evita una herramienta de escritura rota usando bash).

    El problema del «modelo pulido»: los modelos están entrenados para ser educados y a menudo se resisten a autoinculparse. Para que los autodiagnósticos funcionen, la herramienta debe presentarse de forma neutral (p. ej., «report» o «feedback al creador») en lugar de negativa (p. ej., «comportamiento inseguro»). El prompt del sistema debe animar a informar de «cualquier cosa destacable», no solo de «fallos».

    Los experimentos A/B en producción son el flujo de trabajo central una vez que se establecen las señales. Al enviar un cambio (un nuevo prompt, un modelo diferente) a un porcentaje de usuarios y comparar las tasas de señal (como frustración del usuario) contra un grupo de control, los equipos pueden validar mejoras o detectar regresiones en condiciones reales de forma rápida.

    4. La transición de evals a monitorización en producción

    El argumento central de las charlas de Lori Voss y Nicholas Kang es que el paradigma debe desplazarse de depender de «conjuntos de datos dorados» y evaluaciones offline a una monitorización continua en producción. A medida que los agentes se vuelven más complejos y las apuestas más altas, las evaluaciones predefinidas no pueden cubrir todos los comportamientos emergentes.

    La monitorización permite a los equipos moverse más rápido y detectar comportamientos indefinidos y emergentes que las evaluaciones no pueden cubrir. En producción, los agentes interactúan con usuarios reales, sistemas reales y datos reales, generando patrones de fallo imposibles de anticipar en laboratorio.

    Una métrica especialmente útil es la tasa de regeneración (regeneration rate): con qué frecuencia el usuario o el propio agente solicita regenerar una respuesta. Una tasa alta indica problemas de calidad no capturados por otras métricas. Combinada con la tasa de abandono (el usuario cierra la sesión tras una interacción fallida), ofrece una imagen clara de la salud del agente.

    5. Herramientas y plataformas

    El ecosistema de evaluación de agentes incluye plataformas especializadas. Arise Phoenix (la plataforma de AriseAI) ofrece evaluación y observabilidad integradas para agentes. Bench Pro proporciona benchmarks estandarizados para comparar agentes. Brave Trust y DeepMind contribuyen con marcos de evaluación para entornos de investigación.

    La recomendación práctica es empezar con evaluaciones simples (tasa de éxito en tareas de prueba, latencia media) e ir añadiendo capas de complejidad: autodiagnósticos, experimentos A/B, señales implícitas. La clave no es construir el sistema de evaluación perfecto desde el día uno, sino establecer un bucle de retroalimentación que mejore continuamente.


    Fuentes

    • Lori Voss, AriseAI — «Ship Real Agents: Hands-On Evals for Agentic Applications» (AI Engineer). Duración: 2:04:18. URL: https://youtu.be/Xfl50508LZM
    • Nicholas Kang, Mozilla — «Agentic Evaluations at Scale, For Everybody» (AI Engineer). Duración: 20:02. URL: https://youtu.be/Ubwb6NzegyA

    Atribución: Este artículo adapta material de las charlas de Lori Voss (AriseAI) y Nicholas Kang (Mozilla) en el canal AI Engineer.


    Sugerencia de imagen

    Gráfico de dashboards de monitorización mostrando paneles con métricas de agentes: tasa de error, latencia, tasa de regeneración, y señales implícitas. Estilo oscuro con tonos azules y trazas de líneas temporales. Diagrama conceptual, no una captura de pantalla real. Puede generarse como figura abstracta indicando «Generado por IA — representación conceptual».

    Ver también en el glosario: Prompt, Señal

  • Dos minutos para la gloria: la máquina humana del cañón naval español

    Dos minutos para la gloria: la máquina humana del cañón naval español

    TL;DR:
    – La Marina española del siglo XVIII estandarizó la carga de un cañón naval en dos minutos mediante la especialización de roles (cabo, atacador, fogonero, guardafuegos) y el entrenamiento continuo.
    – El Cuerpo de Ingenieros de Marina (1770-1827) creó academias en Barcelona, Cádiz, Cartagena y Ferrol que tecnificaron la artillería, y tratados como el Método de cargar y manejar la artillería de Ciriaco Muller Huici (c. 1850) codificaron esta doctrina.
    – En combate real, la cadencia caía por humo, bajas y mar gruesa; las fuentes británicas de Trafalgar reportan una media inferior a la inglesa (1,5 min), aunque el sistema español destacó en seguridad gracias a los pañoles inundables y la disciplina de los guardafuegos.


    Capítulo 1: El Rugido de la Cureña

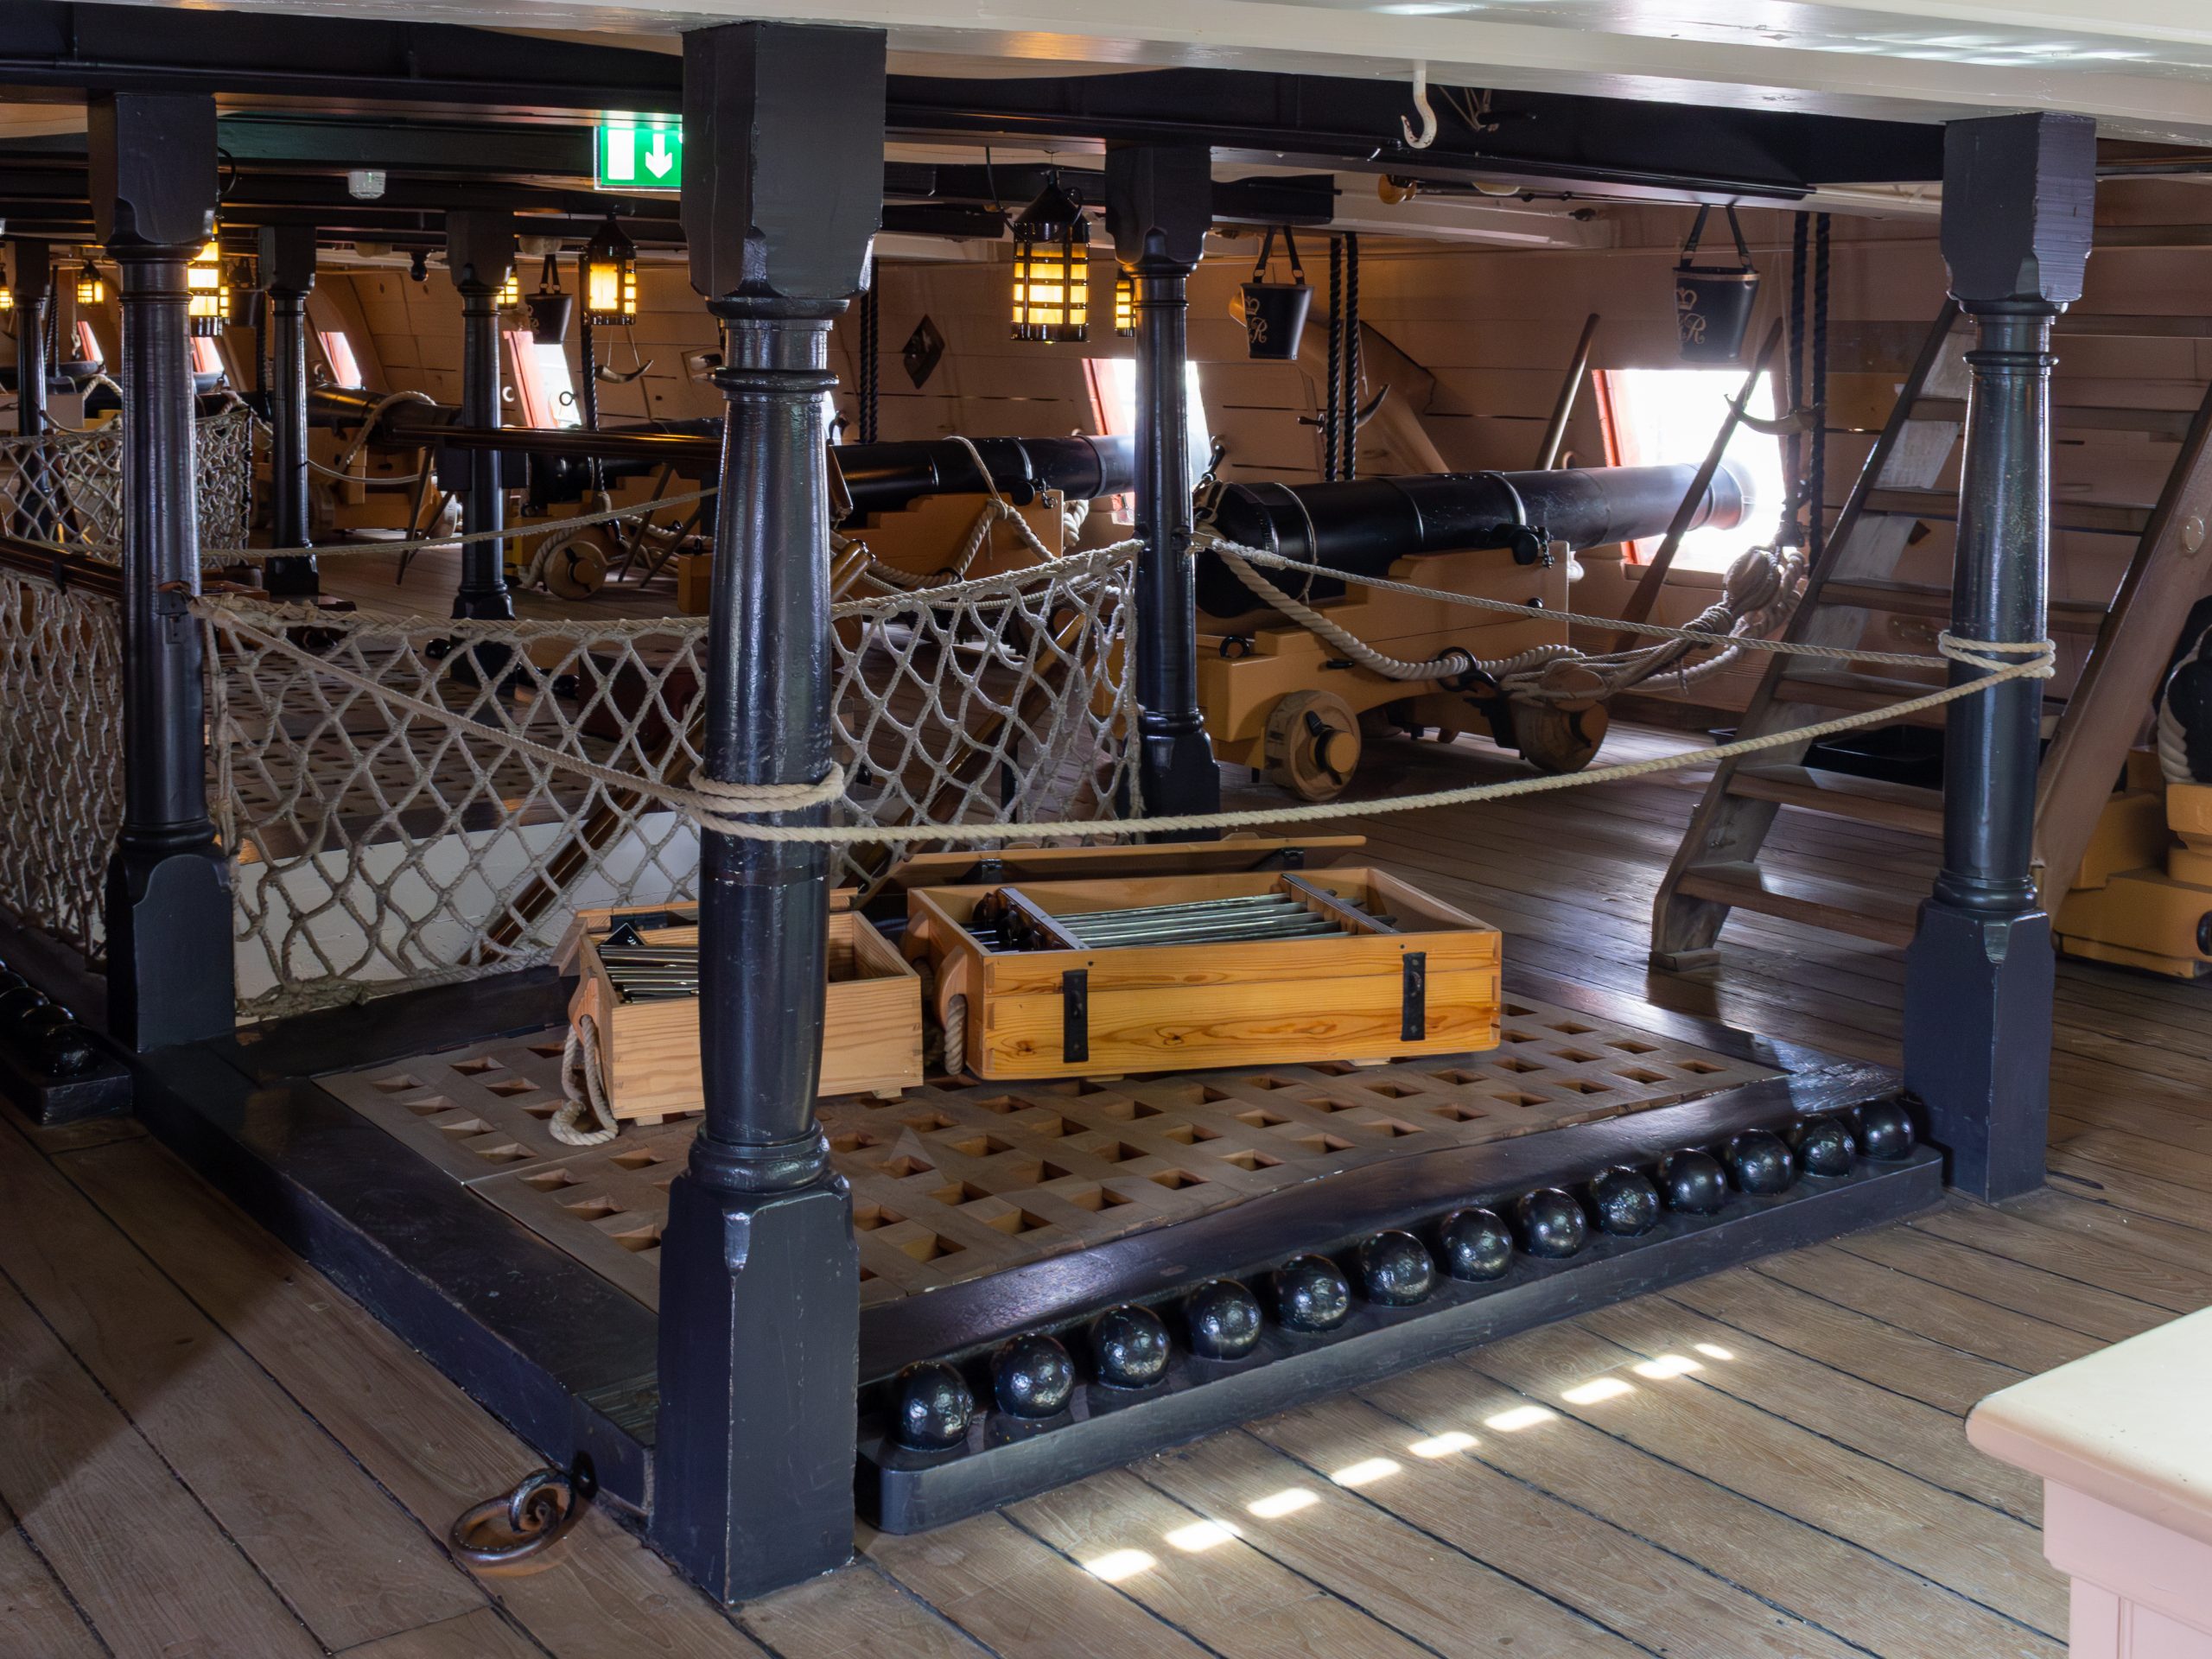
    El artilleria naval española manejo no era un oficio, sino una coreografía de acero y pólvora ensayada hasta el agotamiento. Bajo cubierta, en la penumbra rojiza iluminada por hachas de viento, el humo se espesaba hasta cegar la vista a tres pasos. El calor era insoportable: la combustión de los disparos anteriores había calentado el bronce y el hierro de las cureñas, y el sudor se mezclaba con el polvo de pólvora formando una costra negra sobre los rostros.

    Un cañón de a 24 libras —monstruo de hierro y roble de más de dos toneladas— descansaba sobre su cureña de madera, temblando aún por el último disparo. Ocho figuras fantasmales se movían en torno a él, no como hombres sino como engranajes de un mecanismo de relojería. Cada uno conocía su lugar, su herramienta, su tiempo. No había gritos: las órdenes se transmitían con silbidos y señas porque el fragor del combate lo devoraba todo.

    Este mecanismo no era fruto del azar, sino la culminación de décadas de ciencia, ingeniería y doctrina militar impulsadas por el Cuerpo de Ingenieros de Marina. El corazón de ese mecanismo latía al ritmo de una exigencia casi imposible: un disparo cada dos minutos. Ciento veinte segundos para limpiar, cargar, apuntar y disparar un arma capaz de partir en dos un navío enemigo. ¿Cómo lograban aquellos marineros —muchos de ellos reclutas apenas alfabetizados— semejante precisión bajo el fuego enemigo?

    La respuesta está en la especialización extrema, en un sistema de roles que convirtió a ocho hombres en una sola máquina humana.


    Capítulo 2: El Legado de los Ingenieros (Contexto Histórico)

    Corría el último tercio del siglo XVIII. La Marina española, consciente de su atraso técnico respecto a la Royal Navy, necesitaba maximizar la eficiencia de sus buques. En 1770 se creó el Cuerpo de Ingenieros de Marina, una institución que perduraría hasta 1827 y que estableció academias en los departamentos marítimos de la Real Armada con el objetivo explícito de la tecnificación de la artillería naval.

    Los ingenieros de Marina no eran simples técnicos: eran científicos militares que estudiaban balística, química de la pólvora, resistencia de materiales y organización del trabajo. Su labor era transformar el arte del artillero —heredado de la tradición empírica— en una ciencia reproducible mediante manuales, ordenanzas y ejercicios estandarizados.

    Una posible publicación de nuevas ordenanzas en 1793 buscaba estandarizar la cadencia de fuego. Aunque los documentos originales de 1793 se nos escapan —los archivos históricos a veces son tan elusivos como el humo de las batallas—, su espíritu impregnó reglamentos posteriores, como las contrastadas Ordenanzas de 1796, que sin citar un tiempo concreto, sí imponían una disciplina y una secuencia que hacían posible los dos minutos.

    Este conocimiento se codificaría décadas después, en tratados como el Método de cargar y manejar la artillería de Ciriaco Muller Huici (c. 1850). Conviene aclarar un punto: Muller Huici, nacido en 1825, no fue un ingeniero de aquel primer periodo. Fue el brillante heredero de una saga familiar vinculada a los astilleros de Ferrol —los Muller Huici fueron durante generaciones ingenieros navales— que supo recopilar y perfeccionar la doctrina ya centenaria. Su obra es una cápsula del tiempo que nos permite entender cómo se manejaba un cañón español en el siglo de la Ilustración.


    Capítulo 3: La Coreografía de la Pólvora (La Dotación y la Secuencia)

    Dotación al completo para un Cañón de 24 Libras

    Rol Número Tareas principales
    Cabo de cañón 1 Mando general, supervisión de la carga y puntería final
    Atacador 1 Limpieza del ánima con esponja, introducción y compactación del cartucho, bala y taco
    Fogonero 1 Cebo del fogón con polvorín fino, colocación del estopín o mecha, y disparo
    Guardafuegos 2 Extracción y transporte de cartuchos de pólvora desde el pañol hasta la pieza
    Marineros 3 Movimiento de la cureña, manejo de palancas para puntería y reposición de munición

    Nota: La dotación variaba según el calibre. Para los poderosos cañones de 36 libras, el número ascendía a doce hombres, incorporando marineros adicionales para la extenuante maniobra de mover las toneladas de hierro y madera sobre una cubierta en galerna. No había marineros genéricos; eran especialistas. Esta división del trabajo era el primer secreto de la cadencia.

    Los 120 Segundos Críticos: Secuencia de Carga y Disparo

    graph TD
     A[Paso 1: Limpiar el ánima - 10s] --> B[Paso 2: Introducir cartucho - 5s]
     B --> C[Paso 3: Atacar cartucho, bala y taco - 20s]
     C --> D[Paso 4: Puesta en batería y puntería - 15s]
     D --> E[Paso 5: Cebar fogón - 10s]
     E --> F[Paso 6: ¡Fuego! y retroceso - 5s]
     F --> G[Paso 7: Retorno a batería y ajustes - 55s]
     G --> A
    
    1. Paso 1: ¡Limpiar! (0-10 s) — El atacador introduce la esponja húmeda y el sacatrapos. Un rescoldo encendido en el ánima suponía la muerte instantánea al introducir el nuevo cartucho. La esponja, empapada en agua y vinagre, apagaba cualquier brasa y enfriaba el metal.

    2. Paso 2: El Saquete (10-15 s) — Un guardafuegos entrega el cartucho de pólvora —un saquete de tela con la carga precisa— al segundo artillero, que lo introduce en la boca del cañón. La peligrosidad de este instante es máxima: cualquier chispa o fricción prematura significaba una explosión que mataría a la dotación entera.

    3. Paso 3: ¡Atacar! (15-35 s) — El atacador empuja el cartucho hasta el fondo, luego introduce la bala de hierro y un taco de estopa o cuerda, y compacta todo con golpes secos. Nada debía quedar suelto. Un atacado deficiente restaba potencia al disparo y, peor aún, podía dejar espacio libre que al disparar expandiera el cañón o lo reventara.

    4. Paso 4: Raudos a Batería (35-50 s) — Los marineros desplazan la cureña hacia la portilla, mientras el cabo de cañón ajusta la elevación mediante la cuña de madera y la dirección con la palanca de puntería. En este punto, la precisión lo es todo: un grado de error en el ángulo significaba errar el blanco a 500 metros.

    5. Paso 5: Cebo y Veneno (50-60 s) — El fogonero ceba el fogón con polvorín fino —pólvora de grano muy pequeño que se enciende con facilidad— y coloca un estopín o mecha lenta. La operación requiere pulso firme: un temblor podía derramar el polvorín o desajustar el estopín.

    6. Paso 6: ¡Fuego! (60-65 s) — A la voz del cabo, el fogonero aplica la mecha al fogón. El disparo es un trueno que sacude todo el buque. El retroceso, amortiguado por la cureña y los filásticos (cuerdas gruesas), devuelve la pieza a la posición de carga.

    7. Paso 7: El Reinicio (65-120 s) — Este es el momento de la verdad. El tiempo teórico restante —55 segundos— incluye amarrar la caña para que no se desplace con el balanceo, reajustar la cureña, y preparar todo para el siguiente ciclo. Con mar gruesa o una lluvia de astillas enemigas, este paso consumía más de los teóricos 55 segundos. Aquí es donde el adiestramiento marcaba la diferencia entre un artillero veterano y uno bisoño.


    Capítulo 4: Bajo Fuego y en el Abismo (Realidad vs. Doctrina)

    Los diagramas y las tablas de tiempos son ciencia pura, pero su altar de pruebas era el infierno de la cubierta de combate. Si bien el estándar de los dos minutos era la doctrina heredada que Ciriaco Muller Huici recitaba como un mantra, los informes del fragor de la batalla difieren.

    En Trafalgar (1805), fuentes británicas sugieren que la cadencia media de un navío español era inferior a la suya, cercana al minuto y medio o menos. Las razones son obvias. El humo denso —que cegaba la puntería y obligaba a los guardafuegos a moverse a tientas—, las bajas que diezmaban la dotación (un solo hombre herido rompía la coreografía, pues los roles no eran intercambiables sin entrenamiento específico), y un adiestramiento en escuadra que los informes ingleses consideraban más limitado por falta de pólvora o de práctica continuada en la mar.

    Sin embargo, el sistema creado por el Cuerpo de Ingenieros era el único que permitía intentarlo siquiera. Los procedimientos de seguridad —pañoles inundables, guardafuegos con ropa antiestática, circulación restringida de los saquetes— demostraron su valía al evitar voladuras masivas. En la Guerra de Independencia Española, donde la artillería naval asumió múltiples roles (desde batallas navales hasta defensa de plazas costeras), la doctrina española se mostró robusta y adaptable.


    Capítulo 5: La Huella de Ferrol y la Pluma de Muller Huici (Legado y Conclusión)

    El tronar de aquellos cañones se apagó, pero su memoria técnica quedó grabada. La saga familiar Muller Huici, originaria de Ferrol, produjo durante generaciones ingenieros navales que mantuvieron viva la tradición. Ciriaco Muller Huici, al escribir su Método de cargar y manejar la artillería a mediados del siglo XIX, no redactó un manual de innovación: compuso el epitafio técnico de una era.

    Su tratado es una carta náutica que nos guía de vuelta a las cubiertas del XVIII. Cuando en los documentos de la Revista de Historia Naval nº 147 —fuente primaria de este análisis— o en los viejos tratados leemos los pasos del atacador y el guardafuegos, no estamos leyendo solo instrucciones. Estamos oyendo, en el silencio de los archivos, el pulso implacable de ocho hombres fundidos en uno, el tic-tac de la máquina humana que, durante ciento veinte segundos infinitos, sostuvo el honor y el poder de la Marina española.


    Glosario de este artículo

    Término Definición
    Cureña Armazón de madera sobre ruedas donde se monta el cañón; permite el retroceso controlado tras el disparo.
    Atacador Herramienta de madera con un extremo ensanchado para introducir y compactar el cartucho, la bala y el taco en el ánima del cañón.
    Fogón Orificio en la recámara del cañón por donde se introduce la carga de ignición (polvorín fino) para prender la pólvora del cartucho.
    Guardafuegos Marinero especializado en transportar los cartuchos de pólvora desde el pañol (almacén seguro) hasta la pieza, siguiendo estrictas normas de seguridad.
    Pañol inundable Compartimento del buque donde se almacena la pólvora, diseñado para poder inundarse rápidamente en caso de incendio, evitando explosiones catastróficas.

    Glosario Maestro de Historia Naval


    Preguntas Frecuentes (FAQ)

    1. ¿Los cañones navales españoles realmente disparaban cada dos minutos en combate real?

    El estándar doctrinario era de dos minutos, pero en condiciones reales de combate —humo, bajas, marejada— la cadencia solía ser inferior. Fuentes británicas de Trafalgar reportan que los navíos ingleses alcanzaban un disparo cada minuto y medio, mientras que los españoles se acercaban más a los dos minutos o algo más. La diferencia se debía al entrenamiento continuo y a la mayor experiencia de los marineros británicos en el mar.

    2. ¿Qué hacía especial al sistema de artillería español frente a otras marinas?

    El Cuerpo de Ingenieros de Marina español puso un énfasis inusual en la seguridad y la estandarización. Los pañoles inundables, la disciplina de los guardafuegos y la especialización de roles (ocho hombres para un cañón de 24 libras, cada uno con una tarea concreta) reducían el riesgo de explosiones accidentales y permitían que marineros con poca experiencia individual ejecutaran una maniobra compleja como equipo.

    3. ¿Existe algún tratado original donde se pueda leer el procedimiento completo?

    Sí, la obra clave es Método de cargar y manejar la artillería de Ciriaco Muller Huici (c. 1850), aunque es un texto posterior que recopila doctrina del siglo XVIII. También se conservan ordenanzas de artillería de 1796 en el Archivo General de la Marina en El Viso del Marqués (Ciudad Real). La Revista de Historia Naval nº 147 contiene artículos específicos sobre este tema.


    KIT DE REDES SOCIALES

    Hilo de X (Twitter) — 5 tuits

    1⃣ ** Cada 120 segundos, un cañón español de 24 libras podía vomitar 4 kg de hierro a 500 m.** Pero entre disparo y disparo ocurría la verdadera proeza: 8 hombres ejecutando una coreografía letal bajo cubierta, cegados por el humo. HILO

    2⃣ ** El secreto: especialización total.** No había marineros genéricos. Cada cañón tenía un cabo (mando), un atacador (limpia y carga), un fogonero (dispara) y dos guardafuegos (que traían los saquetes de pólvora desde el pañol con extremas medidas de seguridad).

    3⃣ ** ¡Limpiar es sobrevivir!** Tras disparar, quedaban rescoldos encendidos. Si se metía pólvora nueva, explotaba. El atacador metía primero una esponja empapada en vinagre y agua para enfriar el metal y apagar cualquier chispa. Segundos de pura tensión.

    4⃣ ** La coreografía de la Ilustración.** Una vez cargada la bala y el taco, toda la dotación empujaba las dos toneladas del cañón de vuelta a la portilla, apuntaba usando cuñas de madera y encendía el fogón. Un disparo coordinado y vuelta a empezar.

    5⃣ ** Ciencia bajo el fuego.** Doctrina perfeccionada por el Cuerpo de Ingenieros de Marina y recopilada por Ciriaco Muller Huici en el XIX. La batalla no la decidían solo los cañones, sino la perfecta coreografía de su tripulación. #HistoriaNaval #Artillería #ArmadaEspañola

    Artículos relacionados

  • Roble, Corona y Mar: La madera de Guipúzcoa que armó a la Monarquía Hispánica

    Roble, Corona y Mar: La madera de Guipúzcoa que armó a la Monarquía Hispánica

    TL;DR:
    – En 1574, Felipe II estableció cuotas anuales de plantación de robles en Guipúzcoa, creando el primer sistema de gestión forestal estratégico para la Armada en Europa.
    – El roble guipuzcoano (Quercus robur) proporcionaba las piezas curvas naturales para cuadernas y baos, insustituibles para la construcción de navíos de línea durante dos siglos.
    – A finales del siglo XVIII, la crisis de suministro de madera de calidad ya era evidente: los costes reflejaban la complejidad logística (navío San Isidoro: 211.973 reales; bergantín Diligente: 25.250 reales).


    La Guerra de las Maderas: así denominan los historiadores navales al pulso callado entre la necesidad imperial de madera y la capacidad de los bosques cantábricos para abastecerla. El roble de Guipúzcoa no fue solo la materia prima de la Armada española: constituyó el recurso estratégico que permitió a la Monarquía Hispánica desplegar su poder oceánico durante más de doscientos años. Sin la madera de esos montes, la Gran Armada de 1588 jamás habría zarpado, y los navíos de línea del siglo XVIII nunca habrían cruzado el Atlántico.


    I. Introducción: El árbol y el trono

    Antes de que los ciento treinta navíos de la Gran Armada enfilasen el Canal de la Mancha en 1588, el destino del Imperio se decidió en los bosques de Guipúzcoa. Allí, en las laderas del Cantábrico, el hacha de un cortador derribaba un roble centenario cuyas fibras curvas, moldeadas por décadas de viento y lluvia, terminarían formando las cuadernas de un galeón.

    Felipe II (1556‑1598) comprendió que la madera valía más que el oro. La Armada de la Mar Océana exigía un suministro continuo, programado y de calidad insuperable. El roble de Guipúzcoa, reconocido por su dureza y resistencia, pasó a ser el material esencial de los astilleros. La política forestal de 1574, pionera en Europa, tejió un ciclo de dos siglos que culminó en los buques de finales del XVIII —el navío San Isidoro, la fragata Gloria, el bergantín Diligente— y demostró que el poder naval de la Monarquía Hispánica brotó, literalmente, de la tierra.


    II. Capítulo 1: La semilla que el rey plantó: las cuotas de robles de 1574

    En 1574, Felipe II decretó que todas las localidades peninsulares norteñas situadas a menos de dos leguas del mar o de ríos navegables estaban obligadas a plantar un número fijo de robles cada año. Las cuotas eran supervisadas por las autoridades reales, garantizando el suministro a perpetuidad. No fue una respuesta improvisada: se trató de un plan estratégico a largo plazo. La madera de roble requería décadas para alcanzar la madurez necesaria; el monarca invertía en buques que él no vería.

    Mientras en El Escorial se tallaba la fe en piedra, en los montes vascos se sembraba la defensa del Reino con bellotas. Cada hoyo excavado anticipaba una cuaderna futura. La Diputación Foral de Guipúzcoa colaboró en la ejecución, y la medida se mantuvo en vigor durante siglos, consolidando la industria naval guipuzcoana como una de las más relevantes de la Corona. Gestión forestal en la Monarquía Hispánica


    III. Capítulo 2: El roble de Guipúzcoa, un recurso estratégico moldeado por la naturaleza

    El roble común (Quercus robur) de los bosques guipuzcoanos ofrecía exactamente lo que un constructor naval necesitaba. Las fibras curvas de los ejemplares centenarios proporcionaban piezas para cuadernas (costillas del buque) y baos; la fibra recta se destinaba a quillas y mástiles. No era madera tratada ni contrachapado: la naturaleza generaba las formas curvas de manera espontánea, y los cortadores las aprovechaban.

    De cada roble anciano, el hacha extraía la memoria de un siglo de vientos del Cantábrico, oculta en los anillos que luego soportarían el peso de los cañones. Los bosques se ubicaban cerca de ríos navegables —Deba, Urola, Oria, Urumea—, lo que facilitaba el transporte. La madera guipuzcoana era considerada un recurso de defensa, casi como el oro de Indias. Su gestión silvícola, aunque no del todo documentada, revela saberes empíricos refinados: los taladores seleccionaban árboles según la pieza deseada, y el secado se prolongaba durante meses para evitar alabeos.

    La madera como recurso estratégico en la Edad Moderna


    IV. Capítulo 3: Del bosque a la grada: la cadena de suministro del poder naval

    La ruta del roble desde la montaña hasta el casco del navío era tan precisa como una línea de batalla. A continuación, se representa el flujo logístico de esta cadena:

    graph TD
     A[Bosque de roble (Quercus robur)] --> B[Plantación y gestión según cuotas de 1574]
     B --> C[Tala y despiece por cortadores]
     C --> D[Transporte por ríos hasta el mar]
     D --> E[Astillero: almacenamiento y secado]
     E --> F[Carpinteros de ribera: construcción del casco]
     F --> G[Calafates: impermeabilización]
     G --> H[Botadura y entrega a la Armada]
    

    Descripción del recorrido:

    1. El árbol en el monte: Los cortadores seleccionaban el ejemplar adecuado según la pieza deseada. Un roble de 40‑50 años proporcionaba la fibra recta; uno centenario, las curvas naturales para cuadernas.
    2. Del monte al río: Los troncos se despiezaban en el bosque y se arrastraban hasta los ríos Deba, Urola, Oria o Urumea. El cabotaje completaba el trayecto hasta los astilleros de Pasajes, Deba o Zumaya.
    3. En el astillero: La madera se almacenaba en pilas ventiladas durante meses, a veces años, para un secado controlado que evitara alabeos. Solo entonces pasaba a las manos de los carpinteros de ribera.

    Cada río se convertía en una arteria por la que fluía la madera hacia el corazón del astillero; cada crecida era una oportunidad para impulsar la empresa naval.


    V. Capítulo 4: Carpinteros de ribera y calafates: el arte de dar vida a la madera

    Los carpinteros de ribera y los calafates eran maestros de un saber transmitido de generación en generación. Dominaban las técnicas de construcción a tope y tingladillo, usando herramientas manuales y brea como impermeabilizante.

    Los carpinteros de ribera interpretaban las vetas de la madera como un cirujano lee un cuerpo. En sus gradas, las piezas curvas del roble se convertían en el esqueleto de navíos de línea, fragatas y bergantines. A continuación, se muestran los costes de tres buques representativos de finales del siglo XVIII, según los registros documentados por la historiadora Lourdes Odriozola Oyarbide:

    Buque Tipo Fecha de registro Coste (reales)
    San Isidoro Navío de línea 1791-12-17 211.973
    Gloria Fragata 1793-12-13 235.610
    Diligente Bergantín 1793-02-22 25.250

    Estas cifras reflejan diferencias de tonelaje de arqueo y complejidad constructiva. Un navío de línea como el San Isidoro triplicaba el coste de un bergantín. La maestranza guipuzcoana trabajaba en los mismos astilleros donde, dos siglos antes, se habían armado barcos para la Gran Armada de 1588. Los astilleros vascos en la Edad Moderna


    VI. Capítulo 5: La crisis del siglo XVIII: el precio de la abundancia

    A finales del siglo XVIII, la presión sobre los bosques guipuzcoanos resultaba insostenible. Las cuotas de 1574, aunque mantenían la plantación, no podían compensar la tala intensiva para construir navíos de línea cada vez mayores. La madera de calidad escaseaba y los costes se disparaban. Según el reglamento de 1748 sobre montes y plantíos, se intentó regular la tala, pero la demanda de la Armada era voraz.

    La Gloria, fragata de 1793, costó 235.610 reales, más que el navío San Isidoro, debido a la necesidad de maderas especiales para su arboladura y forro. El bergantín Diligente, más pequeño, costó solo 25.250 reales, pero incluso esa cifra representaba un esfuerzo logístico considerable.

    La crisis anunciaba el fin de un ciclo. Los bosques no podían regenerarse al ritmo de la construcción naval. La solución llegaría con el hierro y el vapor, pero durante dos siglos, el roble de Guipúzcoa sostuvo el poderío naval español.


    Preguntas frecuentes (FAQ)

    1. ¿Por qué era tan importante el roble de Guipúzcoa para la Armada española?
    Porque proporcionaba piezas curvas naturales (cuadernas y baos) que ningún otro material podía igualar en resistencia y durabilidad. Su dureza y flexibilidad lo hacían insustituible para construir cascos capaces de soportar el peso de la artillería y las travesías oceánicas.

    2. ¿Cómo se aseguraba el suministro de madera a largo plazo?
    Mediante las cuotas de plantación de 1574, que obligaban a las localidades costeras a plantar robles anualmente. Esta política forestal, pionera en Europa, garantizaba que siempre hubiera árboles en crecimiento para las generaciones futuras.

    3. ¿Cuándo comenzó la crisis de suministro de madera?
    A finales del siglo XVIII, cuando la construcción de navíos de línea cada vez mayores agotó los bosques más accesibles. Los costes de construcción se dispararon, y la Armada comenzó a buscar alternativas, como el pino o el hierro, aunque ninguna igualaba al roble guipuzcoano.


    Glosario de este artículo

    • Cuaderna: Costilla del buque, pieza curva que forma el esqueleto del casco.
    • Baos: Vigas transversales que soportan las cubiertas.
    • Carpintero de ribera: Artesano especializado en la construcción de barcos de madera.
    • Calafate: Operario que impermeabiliza las juntas del casco con estopa y brea.
    • Toneladas de arqueo: Medida de capacidad interna de un buque, no de desplazamiento.

    Para más términos, consulta el Glosario Maestro de Historia Naval.


    KIT DE REDES SOCIALES

    Hilo de X (Twitter)

    1. 1/5 ¿Sabías que el roble de Guipúzcoa fue el verdadero motor de la Armada española durante 200 años? Sin estos árboles, la Gran Armada de 1588 nunca habría existido.
    2. 2/5 En 1574, Felipe II ordenó plantar robles en todas las localidades costeras del norte. Era una inversión a 50 años vista. Un plan forestal militar sin precedentes en Europa.
    3. 3/5 La madera de roble guipuzcoano proporcionaba las piezas curvas para las cuadernas de los navíos. Cada árbol centenario era una costilla del Imperio.
    4. 4/5 A finales del XVIII la demanda agotó los bosques. El coste de un navío se disparó. La era del roble llegó a su fin con el hierro y el vapor.
    5. 5/5 Más detalles en el artículo completo. Un capítulo olvidado de nuestra historia naval.

    Artículos relacionados

  • Jorge Juan y Santacilia: el marino, científico y espía que reformó la Real Armada

    Jorge Juan y Santacilia: el marino, científico y espía que reformó la Real Armada

    Introducción

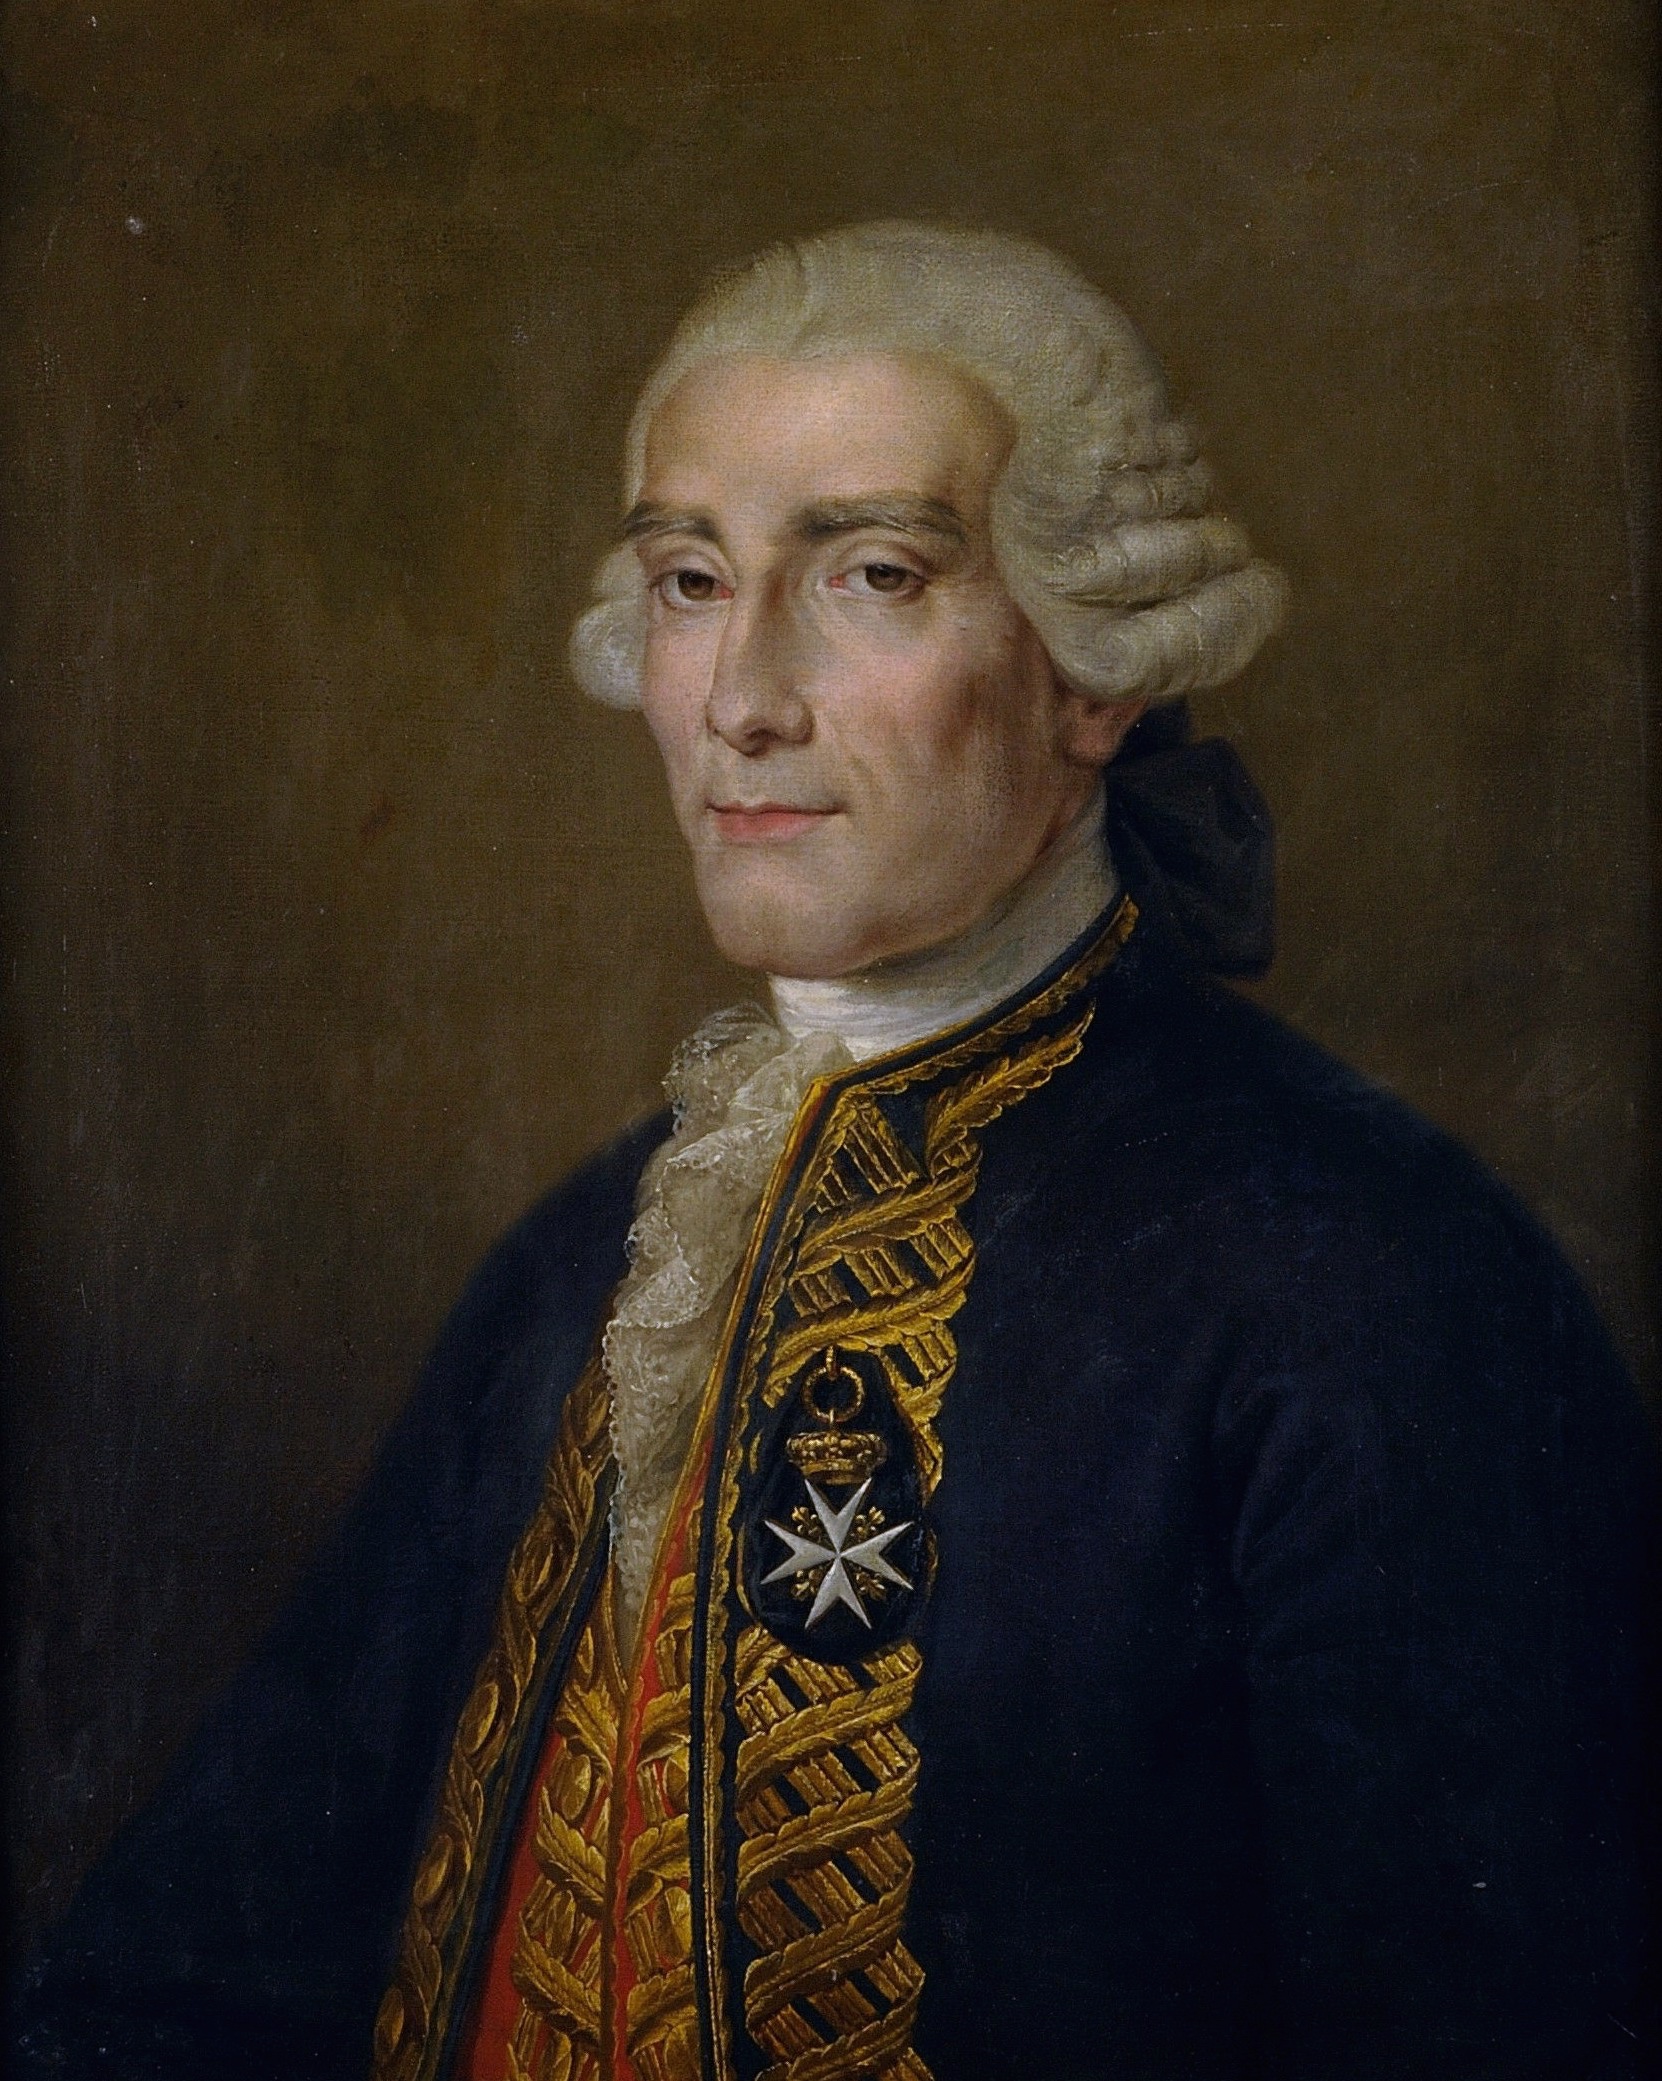
    En la primera mitad del siglo XVIII, la Armada Española arrastraba las consecuencias de la decadencia de los últimos Austrias. La llegada de la dinastía borbónica con Felipe V impulsó reformas urgentes para recuperar el poderío naval, en un contexto de rivalidad creciente con Gran Bretaña por el control de las rutas atlánticas y los territorios americanos. En este escenario emerge la figura de Jorge Juan y Santacilia (1713-1773), un hombre que encarna como pocos la complejidad de su tiempo: marino, ingeniero naval, astrónomo y, según los términos de la época, informante al servicio de la Corona. Su vida combinó la ciencia más rigurosa con la recopilación de información estratégica, convirtiéndose en uno de los artífices de la renovación de la marina ilustrada española.

    Relacionado: Espionaje y acero: Jorge Juan y la renovación técnica

    Relacionado: Jorge Juan y la misión reservada en Inglaterra

    Capítulo I: Formación científica y expedición geodésica

    El camino de Jorge Juan hacia la modernización naval comenzó temprano. En 1729 ingresó en la Real Compañía de Guardiamarinas de Cádiz, la institución de formación de oficiales más importante de la época. Allí, entre 1730 y 1733, alternó operaciones navales con estudios teóricos, una combinación que marcaría su método de trabajo.

    Sin embargo, el punto de inflexión llegó con su participación en la expedición geodésica franco-española al Ecuador (1735-1744). Esta misión, realizada junto al también científico Antonio de Ulloa y bajo la dirección del francés Louis Godin, tenía un objetivo preciso: medir un grado de meridiano terrestre para determinar la forma exacta de la Tierra. No se trataba de un viaje de exploración al estilo colombino, sino de una operación científica de medición que exigía conocimientos avanzados en astronomía, cartografía y geodesia.

    Durante casi una década en tierras americanas, Jorge Juan no solo perfeccionó estas disciplinas, sino que también adquirió una comprensión profunda de la construcción naval que luego resultaría decisiva. La expedición le proporcionó las herramientas intelectuales que aplicaría años después en los astilleros españoles.

    Cronología de hitos clave:
    | Año | Acontecimiento |
    |—–|—————-|
    | 1713 | Nacimiento en Novelda (Alicante) |
    | 1729 | Ingreso en la Real Compañía de Guardiamarinas de Cádiz |
    | 1735-1744 | Expedición geodésica franco-española al Ecuador |
    | 1746-1749 | Estancia en Londres como informante |
    | 1750-1760 | Reforma de la Armada |
    | 1773 | Fallecimiento en Madrid |

    Capítulo II: La misión de espionaje en Londres (1746-1749)

    Tras la expedición, Jorge Juan viajó a Londres con una cobertura oficial como científico ante la Royal Society de Londres, la prestigiosa sociedad científica británica. En realidad, actuaba como informante —o espía, en el sentido del siglo XVIII— al servicio de la Corona española. Sus objetivos eran claros: recopilar información sobre los avances técnicos de la Marina británica, incluyendo construcción naval, artillería y organización logística, y especialmente conocer las intenciones expansionistas británicas en América.

    Las actividades documentadas de Jorge Juan en Inglaterra revelan un trabajo meticuloso. Visitó los astilleros de Deptford y Portsmouth, donde estudió en detalle el HMS Royal George, un navío de 100 cañones que representaba la vanguardia de la ingeniería naval británica. Recopiló planos y especificaciones, y alertó sobre la superioridad de la artillería británica y su sistema de aprovisionamiento.

    El alcance exacto de la información que proporcionó sobre los planes británicos en América no está documentado con precisión. Algunos historiadores sugieren que sus informes influyeron en la política defensiva española, mientras que otros consideran que su impacto fue limitado ante la inacción de la corte. Esta incertidumbre forma parte del legado histórico de Jorge Juan, cuya labor como informante se inscribe en el contexto de la rivalidad naval que marcaría el siglo XVIII.

    Buques clave en la carrera de Jorge Juan:
    | Nombre | Tipo | Cañones | Contexto |
    |——–|——|———|———-|
    | HMS Royal George | Navío de línea británico | 100 | Estudiado en Londres (1746-1749) |
    | San Felipe | Navío de línea español | 70 | Construido bajo su supervisión |
    | Rayo | Navío de línea español | 80 | Construido en Ferrol |
    | Juno | Fragata española | 34 | Representa la modernización de buques menores |

    Capítulo III: La renovación científica e institucional de la Armada (post-1749)

    El regreso a España marcó el inicio de la fase más productiva de Jorge Juan. Con el apoyo de figuras clave como el Marqués de la Ensenada, impulsor de las reformas, y Julián de Arriaga, Secretario de Marina e Indias, puso en práctica lo aprendido durante años de estudio y observación.

    Personas clave en la red de Jorge Juan:
    | Persona | Cargo/Rol | Relación |
    |———|———–|———-|
    | Marqués de la Ensenada | Ministro de Felipe V y Fernando VI | Impulsor de las reformas navales |
    | Julián de Arriaga | Secretario de Marina e Indias | Superior directo en la Armada |
    | Antonio de Ulloa | Compañero en la expedición geodésica | Científico y marino colaborador |
    | Louis Godin | Director francés de la expedición | Jefe científico de la misión al Ecuador |

    Las reformas de Jorge Juan abarcaron tres áreas fundamentales. En construcción naval, aplicó métodos matemáticos avanzados basados en resistencia de materiales e hidrodinámica, introduciendo el uso de modelos a escala y pruebas sistemáticas. Supervisó la construcción de navíos de línea de 70 y 80 cañones —como el San Felipe y el Rayo— en los arsenales de Cartagena y Ferrol, mejorando la estandarización de piezas y la calidad de la madera. Sin embargo, la atribución de los diseños de ciertos navíos a Jorge Juan es controvertida: no sobreviven planos firmados que permitan distinguir su aportación directa de la de otros ingenieros contemporáneos.

    En formación de oficiales, reformó el plan de estudios de la Escuela de Guardiamarinas, incluyendo asignaturas de cálculo, astronomía y navegación científica. También contribuyó a la organización de los astilleros, con Cádiz y Ferrol como principales bases navales, y participó en la fundación del Observatorio de Cádiz.

    El contexto geopolítico —con el Tratado de Madrid (1750) y las tensiones con Portugal— exigía una Armada capaz de competir con Gran Bretaña. Las reformas de Jorge Juan, aunque limitadas por las resistencias institucionales y la falta de recursos, sentaron las bases de la marina ilustrada española.

    Capítulo IV: Incertidumbres y legado final

    El legado de Jorge Juan no está exento de sombras. Dos incertidumbres principales rodean su figura: el alcance exacto de su influencia como informante sobre los planes británicos en América y la atribución de los diseños navales que se le reconocen. Ambas cuestiones reflejan las dificultades de la investigación histórica cuando las fuentes documentales son parciales o inexistentes.

    A pesar de estas limitaciones, su contribución a la modernización de la Armada Española es innegable. Jorge Juan representa el ideal ilustrado de combinar ciencia, técnica y servicio al Estado. Su figura, a medio camino entre el sabio de gabinete y el hombre de acción, encarna las contradicciones y las aspiraciones de una España que buscaba recuperar su lugar en el escenario naval europeo.

    Hoy, cuando visitamos los astilleros de Ferrol o admiramos la historia del Navío Santísima Trinidad, recordamos que tras esos logros hubo hombres como Jorge Juan, capaces de navegar entre la ciencia y el secreto, entre la lealtad a su rey y la necesidad de mirar al enemigo para aprender de él. Su vida nos recuerda que la grandeza de una marina no depende solo de sus barcos, sino de la inteligencia y la determinación de quienes los conciben y construyen.


    Metadatos de Generación

    • Modelo: unknown
    • Latencia: 0.00s

    Artículos relacionados

    Ver también en el glosario: Artículos Relacionados, Artículos Relacionados, Artículos Relacionados, Navío De Línea, Astilleros, Metadatos, Oficial, Fragata

  • Liderazgo en equipos de alto rendimiento

    Liderazgo en equipos de alto rendimiento

    Liderazgo en equipos de alto rendimiento

    liderazgo equipos alto rendimiento

    Relacionado: Liderazgo en equipos técnicos de IA

    1. El mito del líder carismático

    Durante décadas hemos vendido la idea de que el liderazgo empresarial tiene rostro: Steve Jobs, Jack Welch, Elon Musk. La historia del «líder visionario que lo cambia todo a fuerza de voluntad» vende libros y llena conferencias. Solo que los datos no la sostienen.

    Un meta-análisis de 130 estudios publicado en The Leadership Quarterly lo deja claro: el carisma explica menos del 15% de la varianza en el rendimiento del equipo. Lo que de verdad mueve la aguja no es la visión ni el magnetismo personal. Es la capacidad de generar confianza psicológica, poner objetivos claros encima de la mesa y diseñar estructuras que hagan fácil colaborar.

    2. Confianza psicológica: el factor olvidado

    Amy Edmondson, de Harvard, dio nombre a algo que los buenos equipos ya intuían: la «seguridad psicológica». Es la certeza compartida de que aquí se puede arriesgar, disentir, meter la pata y proponer locuras sin que te caiga un marrón encima.

    Google lo confirmó con su Proyecto Aristóteles (2012-2017). Analizaron cientos de equipos buscando la fórmula del alto rendimiento. El hallazgo fue rotundo: la seguridad psicológica ganaba por goleada. Por encima de la composición del equipo, de la experiencia individual, de los incentivos económicos.

    Si quieres un equipo de alto rendimiento, tu trabajo no es «motivar». Es crear el suelo donde la motivación intrínseca pueda echar raíces. Eso significa celebrar los errores como lo que son: datos. Significa matar la cultura de buscar culpables. Y significa ir tú primero: reconocer tus límites, decir «no sé» cuando no sabes, y pedir ayuda cuando la necesitas.

    3. Dirección sin microgestión

    El dilema clásico: cómo dar rumbo sin acabar controlando cada movimiento. La investigación apunta a tres claves:

    Qué (objetivos claros). El líder define a dónde vamos y por qué. La ambigüedad en los objetivos es la frustración número uno en equipos de conocimiento.

    Cómo (autonomía). Una vez claro el qué, el equipo decide el cómo. Microgestionar es la forma más rápida de matar la iniciativa y la creatividad.

    Obstáculos (tu trabajo real). Tu labor no es vigilar. Es conseguir recursos y quitar de en medio las trabas organizativas que frenan al equipo.

    4. Liderazgo en la era del trabajo distribuido

    Lo remoto e híbrido ha complicado la ecuación. Los equipos distribuidos exigen comunicación más explícita, procesos más cuidados y una apuesta deliberada por cuidar las relaciones.

    Lo que está funcionando: reuniones individuales semanales de media hora (no para revisar tareas, sino para hablar de carrera, desarrollo y cómo está la gente). Documentar decisiones en asíncrono. Rituales que mantengan el pegamento social: retiros trimestrales, cafés virtuales sin agenda.

    La IA no ha hecho el liderazgo más complejo técnicamente. Lo ha hecho más exigente humanamente. La IA automatiza tareas. No construye confianza, no inspira propósito, no crea cultura. Eso sigue siendo tuya la responsabilidad. Y no hay algoritmo que la sustituya.

    5. Fuentes

    • Edmondson, A. C. (2018). The Fearless Organization: Creating Psychological Safety in the Workplace for Learning, Innovation, and Growth. Wiley.
    • Google re:Work (2017). Project Aristotle: Understanding Team Effectiveness.
    • Dweck, C. S. (2006). Mindset: The New Psychology of Success. Random House.
    • Sinek, S. (2009). Start with Why: How Great Leaders Inspire Everyone to Take Action. Portfolio.
    • Collins, J. (2001). Good to Great: Why Some Companies Make the Leap… and Others Don’t. HarperBusiness.
    • Harvard Business Review (2024). «Leadership in the Age of AI». HBR Special Report.

    Ver también en el glosario: Liderazgo

  • La cuna del poder naval español: Ferrol y el despertar de la Real Armada

    La cuna del poder naval español: Ferrol y el despertar de la Real Armada

    astilleros de Ferrol

    Relacionado: Ciencia y poder naval en la Ilustración

    Relacionado: NAV-S25 · Ciencia y poder naval en la Ilustracion

    Introducción

    Corría el año 1726 cuando España, humillada tras la Guerra de Sucesión, contemplaba con amargura su flota: apenas una treintena de navíos anticuados frente a los más de trescientos que enarbolaban la enseña británica. Felipe V, primer monarca borbónico, comprendió que sin un poder naval capaz de proteger las rutas de Indias, el imperio sería presa fácil. La decisión que tomó cambiaría para siempre la historia marítima de España: apostar por un puerto profundo en el fin del mundo, una ría gallega donde el Atlántico se abrazaba con la costa. De las cenizas del prestigio perdido emergería una flota capaz de desafiar a los mares.


    Capítulo 1: La visión de Felipe V

    Un puerto profundo en el fin del mundo: la apuesta de un rey por el Atlántico

    El contexto estratégico era desolador. Inglaterra dominaba las rutas oceánicas con sus escuadras modernas, mientras que los arsenales españoles, dispersos y mal equipados, apenas podían mantener una docena de navíos operativos. Felipe V necesitaba un arsenal atlántico que protegiera las rutas de Indias y contrarrestara la amenaza británica. La ría de Ferrol ofrecía lo que ningún otro puerto peninsular podía: un fondeadero natural resguardado por las rías altas, protegido de los vientos dominantes y los ataques enemigos por una geografía que parecía diseñada por la providencia.

    En 1726, la orden real cayó como un trueno sobre la Galicia rural. Las obras comenzaron entre dificultades titánicas: el terreno pedregoso, la falta de financiación y la escasez de mano de obra cualificada. Ingenieros franceses llegaron para diseñar los primeros diques y gradas, aún rudimentarios, mientras los carpinteros de ribera locales aprendían nuevas técnicas. El olor a brea y madera recién cortada comenzó a impregnar la ría.

    Pero Felipe V murió en 1746, dejando el proyecto a medio construir. El rey soñó con una armada poderosa; su hijo, Fernando VI, la convertiría en realidad.


    Capítulo 2: El impulso de Fernando VI y la mano de Ensenada

    Del plano al acero: cómo un ministro ilustrado transformó una ría en el mayor arsenal de España

    Fernando VI accedió al trono en 1746 con una obsesión: completar el arsenal que su padre había iniciado. Convertir Ferrol en prioridad nacional significó movilizar recursos sin precedentes. Entre 1750 y 1760, los diques, gradas y almacenes principales se completaron, transformando la ría en el principal centro de construcción de navíos de línea de la Real Armada.

    La estructura jerárquica que gobernaba este coloso naval era tan precisa como un mecanismo de relojería:

    graph TD
     A[Rey: Felipe V / Fernando VI] --> B[Secretario de Marina e Indias]
     B --> C[Marqués de la Ensenada]
     C --> D[Superintendente del Arsenal]
     D --> E[Ingenieros navales: Jorge Juan]
     E --> F[Maestros de ribera]
     F --> G[Carpinteros, calafates, herreros]
    

    El organigrama siguiente muestra cómo las decisiones reales se traducían en tablones de roble y velas de lino. En la cúspide, el Marqués de la Ensenada, verdadero artífice del resurgir naval, impulsaba desde Madrid las órdenes que llegaban al Superintendente del Arsenal, quien a su vez coordinaba a ingenieros como Jorge Juan, maestro en el arte de convertir árboles en navíos.

    La logística del arsenal era una sinfonía de materiales traídos de media Europa. Los almacenes de jarcia almacenaban cuerdas trenzadas en Cádiz; el velamen llegaba de los telares catalanes; las fundiciones de anclas y cañones rugían día y noche; los diques de carena permitían reparar los cascos sin varar los navíos. Cada navío era una sinfonía de materiales traídos de media Europa.

    Ferrol ya no era una promesa; era una realidad en funcionamiento. Pero quedaba un desafío: unificar la construcción naval bajo un solo techo.

    [DEFINITION_BLOCK]
    Sistema de Departamentos: Estructura administrativa creada por el Marqués de la Ensenada que dividía la costa española en tres departamentos marítimos (Ferrol, Cádiz y Cartagena), cada uno con su arsenal, astilleros y flota asignada. Ferrol quedó como cabecera del Departamento del Norte, responsable de la construcción y mantenimiento de los navíos que operaban en el Atlántico.
    [/DEFINITION_BLOCK]


    Capítulo 3: Guarnizo se apaga, Ferrol se enciende – El navío «Santo Domingo»

    El último clavo en Guarnizo y el primer orgullo de Ferrol

    El astillero de Guarnizo, en Cantabria, había sido durante décadas el orgullo de la construcción naval española. Sus gradas habían visto nacer navíos que surcaron los mares, pero el tiempo y la falta de inversión lo habían condenado al ostracismo. En 1768, tras entregar su última obra, cerró sus puertas para siempre.

    Esa última obra era el navío «Santo Domingo», un coloso de 70 cañones que simbolizaba el cambio de era. Setenta bocas de fuego que rugirían en el Atlántico. Con una eslora de 50 metros, manga de 14 y un desplazamiento de 1.500 toneladas, su casco de roble y pino estaba forrado con planchas de cobre para evitar la broma, ese temido teredo navalis que devoraba la madera en aguas cálidas. La artillería se organizaba en dos baterías: una cubierta con cañones de a 24 libras y otra con piezas de a 12, capaces de vomitar hierro contra cualquier enemigo.

    La siguiente tabla muestra cómo dos astilleros, separados por centenares de kilómetros, compartieron un mismo navío, pero destinos opuestos:

    Astillero Periodo activo Navíos emblemáticos Cañones
    Ferrol Siglo XVIII-XIX Santo Domingo (1768) 70
    Guarnizo Hasta 1768 Santo Domingo (1768) 70

    Mientras Guarnizo se apagaba, Ferrol se encendía. La centralización permitió estandarizar piezas y reducir costes: las mismas cureñas, los mismos pernos, los mismos calibres. La construcción en serie en Ferrol permitió estandarizar piezas y reducir costes, aunque la dependencia de maderas del Báltico y la península limitaba el ritmo. Pero la calidad aumentó, y con ella, el orgullo de una nación.

    [DEFINITION_BLOCK]
    Dique de la Campana: Obra hidráulica pionera en el arsenal de Ferrol, construida bajo la dirección de Jorge Juan. Consistía en un dique seco con compuertas que permitían inundar y vaciar el recinto para la reparación de navíos sin necesidad de vararlos. Su nombre proviene de la campana que señalaba el inicio y fin de las operaciones.
    [/DEFINITION_BLOCK]


    Capítulo 4: Luces y sombras de la centralización

    ¿Un solo arsenal para todo un imperio? El debate que nunca se cerró

    La centralización en Ferrol trajo ventajas innegables: estandarización, control de calidad, especialización de la mano de obra. El arsenal se convirtió en la cuna del poder naval español, un organismo vivo que respiraba brea y sudor. La protección natural de la ría, resguardada por las rías altas, ofrecía una defensa que ningún otro puerto podía igualar.

    Sin embargo, las incertidumbres planeaban sobre el proyecto. Aunque los registros no permiten afirmar con certeza cuántos navíos exactos nacieron en Ferrol bajo Fernando VI, debido a la pérdida de documentos en incendios posteriores, los historiadores debaten si el modelo centralizado fue más eficiente que el sistema previo de múltiples arsenales como Guarnizo. Las fuentes de suministro se alejaron: las maderas del Báltico debían recorrer miles de kilómetros, y los costes de transporte aumentaron. Algunos historiadores señalan que el sistema previo de múltiples arsenales permitía mayor flexibilidad y menores costes logísticos.

    Pero a pesar de las dudas, Ferrol fue el corazón de la Real Armada durante décadas. La decisión de Felipe V y Fernando VI marcó el futuro naval de España. El martilleo de los carpinteros no cesaba ni de noche; el arsenal era un organismo vivo que respiraba brea y sudor.

    [FAQ_BLOCK]
    ¿Por qué se eligió Ferrol como arsenal naval principal?
    La elección de Ferrol respondió a criterios estratégicos y geográficos. Su puerto profundo, protegido por las rías altas, ofrecía un fondeadero natural resguardado de los vientos dominantes y los ataques enemigos. Además, su posición en el Atlántico norte permitía controlar las rutas de Indias y responder rápidamente a amenazas británicas. La profundidad de la ría permitía la entrada de navíos de gran calado, algo que otros puertos gallegos no podían ofrecer.
    [/FAQ_BLOCK]

    [FAQ_BLOCK]
    ¿Qué innovaciones introdujo Jorge Juan en la construcción naval?
    Jorge Juan, ingeniero naval y científico, introdujo en Ferrol el sistema de construcción francés, con cascos más esbeltos y velámenes optimizados. Diseñó el Dique de la Campana, primer dique seco de España, y estandarizó las piezas de artillería. También implementó el forro de cobre en los cascos para protegerlos de la broma, y desarrolló métodos de cálculo para optimizar la estabilidad y velocidad de los navíos.
    [/FAQ_BLOCK]


    Conclusión

    Desde la ría gallega, la madera, el cobre y el coraje se fundieron en navíos que surcaron los mares, llevando el nombre de España hasta los confines del mundo. La ambición de dos reyes y la pericia de ingenieros y carpinteros dieron a España una flota digna de su imperio. Ferrol no fue solo un arsenal: fue el símbolo de una nación que se negaba a declinar. Allí, donde el Atlántico besa la costa, nació el poder naval que durante décadas mantuvo a raya a los enemigos de España.


    Para profundizar en la navegación de la época, consulta nuestro artículo sobre [cómo navegaban los barcos antiguos]. Y si quieres conocer el mayor navío de la historia, descubre la historia del [navío Santísima Trinidad].


    Metadatos de Generación

    • Modelo: unknown
    • Latencia: 0.00s

    Artículos relacionados

    Ver también en el glosario: Artículos Relacionados, Artículos Relacionados, Artículos Relacionados, Estabilidad, Real Armada, Astilleros, Dique Seco, Metadatos

  • Viento en las velas, muerte en las entrañas: la medicina a bordo en la era de la vela

    Viento en las velas, muerte en las entrañas: la medicina a bordo en la era de la vela

    Viento en las velas, muerte en las entrañas: cómo la Royal Navy venció al escorbuto antes de saber qué era

    TL;DR:
    – Durante siglos, el escorbuto mató a más marineros que todas las batallas navales juntas.
    – La medicina a bordo se basaba en la teoría humoral y sangrías, ineficaces contra enfermedades carenciales.
    – El ensayo de James Lind en 1747 demostró la eficacia de los cítricos, pero la Royal Navy no los adoptó hasta 1795.

    La medicina naval española siglo xviii fue un campo de batalla silencioso donde la teoría humoral chocaba contra un enemigo invisible que mataba más que el hierro enemigo. Este artículo explora cómo la lucha contra el escorbuto obligó a cirujanos y almirantazgos a repensar la sanidad a bordo.


    Capítulo 1: El enemigo invisible

    En 1744, el almirante George Anson regresó a Inglaterra tras su circunnavegación con un solo navío de los seis que zarpaban y apenas 188 hombres de los 1.900 originales. No fueron los cañones españoles la causa, sino el escorbuto. Durante los siglos xvi al xviii, la mortalidad a bordo por esta dolencia superaba a la de cualquier combate. Los marineros morían por la falta de ácido ascórbico (contenido en cítricos y alimentos frescos), aunque entonces no existía el concepto de vitamina.

    Los síntomas eran brutales: encías esponjosas que sangraban, dientes que caían, hematomas espontáneos, heridas que no cicatrizaban, debilidad extrema y muerte. Un cronista lo describió: «El hombre se deshace desde dentro, como un barco podrido que se hunde lentamente». El remedio existía en tierra, pero la teoría de los humores y la logística de conservación lo mantuvieron oculto.


    Capítulo 2: Sangrías y galletas podridas

    Según la teoría humoral, el cuerpo se regía por cuatro fluidos: sangre, flema, bilis amarilla y bilis negra. La enfermedad era un desequilibrio, y la sangría la herramienta principal para restablecerlo. En los barcos, el cirujano barbero (siglo xvi) o cirujano de a bordo (xviii) la ejecutaba con lancetas y escarificadores. Las amputaciones se hacían sin anestesia, a punta de ron.

    En la Armada Española del siglo xviii, los Colegios de Cirugía (Cádiz, Barcelona) profesionalizaron al cirujano de la Real Armada, pero la sangría seguía siendo rutinaria para cualquier dolencia. El reglamento de 1748 prescribía sangrías «para evacuar los humores viciados». Era inútil y contraproducente.

    La dieta era nefasta: bizcocho agusanado, carne salada, legumbres secas, queso rancio y alcohol. La combinación de teoría humoral + dieta carencial creaba la catástrofe sanitaria.

    Aspecto Royal Navy (s. xviii) Armada Española (s. xviii)
    Formación del cirujano Empírica + hospitales Colegios de Cirugía desde 1748
    Tratamiento escorbuto Sangrías, elixires, hasta Lind (1747) Sangrías, remedios herbales, jarabes
    Dieta base Bizcocho, carne salada, queso Bizcocho, carne salada, garbanzos, vino
    Adopción de cítricos Oficial en 1795 Limitada hasta bien entrado el s. xix

    Capítulo 3: El remedio fantasma

    Ya en 1617, John Woodall recomendaba jugo de limón en The Surgeon’s Mate. La recomendación cayó en saco roto un siglo. Marinos españoles y holandeses conocían los beneficios de naranjas y limones, pero sin autoridad central que impusiera su uso, el conocimiento se perdía. La medicina naval española siglo xviii carecía de higiene preventiva. La tradición humoral y el costo de transportar fruta fresca eran obstáculos formidables.


    Capítulo 4: Un experimento entre cañones

    En 1747, a bordo del HMS Salisbury, James Lind diseñó uno de los primeros ensayos clínicos de la historia. Doce marineros con escorbuto, seis parejas, seis tratamientos: sidra, elixir de vitriolo, vinagre, agua de mar, nuez moscada, y dos naranjas y un limón al día.

    A los seis días, los que recibieron cítricos se recuperaron. Los demás apenas mejoraron. Lind publicó en 1753 (A Treatise of the Scurvy) métodos para conservar el zumo y recomendó su uso sistemático. Su mérito fue la sistematicidad, pero el establishment naval tardó décadas en aceptarlo.


    Capítulo 5: La inercia de los almirantazgos

    La evidencia existía desde 1747, pero la Royal Navy no adoptó el limón hasta 1795. La teoría humoral seguía dominando, el costo logístico era alto, y proveedores de sidra y vinagre presionaban en contra. Capitanes como James Cook (dieta variada con chucrut y verduras) y el médico Gilbert Blane inclinaron la balanza. Desde 1795, todo barco llevaba jugo de limón en barriles con alcohol. La incidencia se desplomó: los marinos británicos fueron los «limeys».

    En la Armada Española, la adopción fue lenta. Los Colegios de Cirugía incluyeron a Lind, pero la falta de autoridad sanitaria central y las guerras napoleónicas retrasaron la sistematización hasta el siglo xix. Las condiciones mejoraron, pero no alcanzaron la eficiencia británica.


    Preguntas frecuentes (FAQ)

    1. ¿Qué es la teoría humoral y por qué influyó en la medicina naval?
    Postulaba que la salud dependía del equilibrio entre cuatro fluidos. Justificaba sangrías para casi cualquier enfermedad, incluido el escorbuto, empeorando a los pacientes.

    2. ¿Por qué tardó tanto la Royal Navy en adoptar los cítricos?
    Inercia del paradigma humoral, costos logísticos, resistencia comercial y falta de autoridad sanitaria. Fueron necesarios Cook y Blane.

    3. ¿Cómo era la formación de los cirujanos en la Armada Española del siglo xviii?
    Los Colegios de Cirugía (Cádiz, Barcelona) establecieron exámenes y protocolos, pero la enseñanza seguía basada en la teoría humoral. Sangrías y amputaciones continuaron rutinarias hasta el siglo xix.


    Glosario de este artículo

    • Teoría humoral: Paradigma médico del equilibrio entre cuatro fluidos. Sustentó las sangrías hasta el siglo xix.
    • Cirujano barbero: Profesional empírico de sangrías, extracciones y amputaciones (siglos xvi-xvii).
    • Colegios de Cirugía: Instituciones borbónicas (Cádiz, Barcelona) para profesionalizar la cirugía naval.
    • Escorbuto: Enfermedad carencial por déficit de ácido ascórbico. Principal causa de muerte en travesías oceánicas hasta finales del siglo xviii.
    • Ensayo clínico: Estudio comparativo controlado. El de Lind (1747) es de los primeros documentados.

    Enlace al glosario maestro

    Consulta nuestro Glosario Maestro de Historia Naval para más términos y definiciones.


    Artículos relacionados

  • Poda de vocabulario + Continual Pre-training: adapta cualquier LLM al español

    Poda de vocabulario + Continual Pre-training: adapta cualquier LLM al español

    Poda de vocabulario + Continual Pre-training: adapta cualquier LLM al español

    En los artículos previos vimos que cada idioma necesita su propio tokenizador. Entrenamos uno con 128.000 tokens específico para español que reduce los tokens en un 59 % frente al de GPT-2.

    Relacionado: Dos minutos para la gloria: la máquina humana del cañón naval español

    Relacionado: Poda de vocabulario + Continual Pre-training: adapta cualquier LLM al español

    Pero hay un problema: los modelos modernos como Llama 3.2 3B ya no dejan cambiar el tokenizador. El tokenizador está incrustado en el modelo: sus matrices de embedding (input) y LM head (output) tienen una fila por cada token del vocabulario. Si el tokenizador tiene 128.000 tokens, esas matrices ocupan ~1 GB de VRAM solo almacenando tokens de idiomas que nunca vas a usar.

    La solución es la poda de vocabulario (Vocabulary Pruning). Consiste en:

    1. Escanear qué tokens del vocabulario se usan realmente en español
    2. Podar el resto — eliminar cirílico, kanjis, árabe, etc.
    3. Re-mapear los IDs para que sean contiguos
    4. Reducir las matrices del modelo al nuevo tamaño
    5. Hacer continual pre-training con corpus español para que el modelo se adapte a su nuevo vocabulario reducido

    En este artículo lo hacemos paso a paso con TinyLlama 1.1B (modelo abierto, sin autenticación, cabe en cualquier GPU). Los mismos pasos aplican a Llama 3.2 3B, Mistral, o cualquier modelo de la familia Llama.


    El problema: vocabularios multilingües desaprovechados

    Los modelos actuales se entrenan con vocabularios enormes para cubrir todos los idiomas del mundo:

    Modelo Tokens en vocabulario
    GPT-2 (solo inglés) 50.257
    Llama 3 / 3.1 128.000
    Llama 3.2 128.000
    Mistral 32.768
    Gemma 2 256.000

    Cada token en el vocabulario necesita una fila en la matriz de input embeddings (que convierte IDs en vectores) y otra en la de output embeddings / LM head (que convierte vectores en logits).

    En TinyLlama 1.1B (32.000 tokens, dimensión 2048):

    Input embeddings:  32.000 × 2048 = 65,5 millones de parámetros
    Output LM head:    32.000 × 2048 = 65,5 millones de parámetros
    Total embeddings:  131,0 millones de parámetros (11,9 % del modelo)
    

    En Llama 3.2 3B (128.000 tokens, dimensión 4096):

    Input embeddings:  128.000 × 4096 = 524,3 millones de parámetros
    Output LM head:    128.000 × 4096 = 524,3 millones de parámetros
    Total embeddings:  1.048,6 millones de parámetros (~33 % del modelo)
    

    Un tercio del modelo se dedica a almacenar vectores para tokens cirílicos, kanjis, escritura árabe, caracteres devanagari… que si trabajas solo en español nunca vas a usar.


    Paso 1: Escanear qué tokens se usan realmente

    Primero necesitas un corpus representativo de español. Cuanto más variado, mejor. Para esta demo usamos ~2 MB de texto en español (artículos publicados, borradores del blog, y contenido técnico de IA).

    from transformers import AutoTokenizer
    from collections import Counter
    
    model_id = "TinyLlama/TinyLlama-1.1B-Chat-v1.0"
    tokenizer = AutoTokenizer.from_pretrained(model_id)
    
    with open("corpus_espanol.txt", "r", encoding="utf-8") as f:
        corpus = f.read()
    
    used_ids = set()
    freqs = Counter()
    chunk_size = 100_000
    
    for i in range(0, len(corpus), chunk_size):
        chunk = corpus[i:i + chunk_size]
        ids = tokenizer.encode(chunk)
        used_ids.update(ids)
        freqs.update(ids)
    
    # Preservar tokens especiales (<s>, </s>, <pad>, etc.)
    used_ids.update(tokenizer.all_special_ids)
    saved_ids = sorted(list(used_ids))
    

    Resultado con TinyLlama 1.1B:

    Vocabulario total:          32.000 tokens
    Tokens usados en español:   13.713 tokens
    Tokens podables:            18.287 tokens
    Reducción:                   57,1 %
    

    Solo el 43 % del vocabulario de TinyLlama se usa para texto en español. El 57 % restante son tokens para otros idiomas que podemos eliminar sin perder funcionalidad.

    Los tokens más frecuentes en nuestro corpus español son los esperados: espacios, puntuación, artículos, preposiciones y palabras completas como «aprendizaje», «modelo», «datos».


    Paso 2: Podar el tokenizer.json

    El tokenizer de Hugging Face guarda su vocabulario en un archivo tokenizer.json. Basta con quedarse solo con los tokens que usamos y reasignarles IDs contiguos:

    import json
    
    # Cargar tokenizer.json
    with open("tokenizer.json", "r") as f:
        tok_data = json.load(f)
    
    old_vocab = tok_data["model"]["vocab"]
    old_to_new = {old_id: new_id for new_id, old_id in enumerate(saved_ids)}
    
    # Nuevo vocabulario: solo los tokens que conservamos
    new_vocab = {}
    for token_str, old_id in old_vocab.items():
        if isinstance(old_id, int) and old_id in old_to_new:
            new_vocab[token_str] = old_to_new[old_id]
    
    tok_data["model"]["vocab"] = new_vocab
    tok_data["model"]["added_tokens"] = [
        t for t in tok_data["model"].get("added_tokens", [])
        if t.get("id") in old_to_new
    ]
    
    with open("tokenizer.json", "w") as f:
        json.dump(tok_data, f, ensure_ascii=False, indent=2)
    
    print(f"Tokenizer.json: {len(old_vocab)} → {len(new_vocab)} tokens")
    

    Paso 3: Podar las matrices del modelo

    Las matrices embedding y lm_head tienen una fila por token. Creamos matrices nuevas con solo las filas de los tokens que conservamos:

    import torch
    from transformers import AutoModelForCausalLM
    
    model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype=torch.float32)
    
    old_emb = model.get_input_embeddings()
    old_head = model.get_output_embeddings()
    
    new_emb_weight = torch.zeros(len(saved_ids), old_emb.weight.shape[1], dtype=old_emb.weight.dtype)
    new_head_weight = torch.zeros(len(saved_ids), old_head.weight.shape[1], dtype=old_head.weight.dtype)
    
    with torch.no_grad():
        for new_id, old_id in enumerate(saved_ids):
            new_emb_weight[new_id] = old_emb.weight[old_id]
            new_head_weight[new_id] = old_head.weight[old_id]
    
    # Asignar las nuevas matrices
    model.resize_token_embeddings(len(saved_ids))
    
    # Copiar los pesos podados
    with torch.no_grad():
        model.get_input_embeddings().weight.copy_(new_emb_weight)
        model.get_output_embeddings().weight.copy_(new_head_weight)
    
    model.save_pretrained("./modelo-podado-es")
    

    Resultado con TinyLlama 1.1B:

    Matriz Antes Después Ahorro
    Input embeddings 262,1 MB 112,3 MB 149,8 MB
    LM head 262,1 MB 112,3 MB 149,8 MB
    Total (fp32) 524,3 MB 224,7 MB 299,6 MB
    Total (fp16, GPU) 262,1 MB 112,3 MB ~150 MB

    En una GTX 1070 de 8 GB, esos 150 MB pueden ser la diferencia entre que un modelo quepa o no quepa en VRAM. Y sin perder ninguna capacidad en español — solo eliminamos tokens de otros idiomas.


    Paso 4: Verificar que el modelo funcione

    Después de la poda, las secuencias de tokens de cualquier texto en español se conservan exactamente igual. Los IDs cambian (porque reasignamos a contiguos), pero el significado es el mismo:

    Original: "Hola mundo, esto es una prueba del modelo podado."
    IDs originales:  [1, 379, 2963, 13864, 29892, 18261, 831, 1185, 28854, 2291, 628, 29472, 2532, 912, 29889]
    IDs podados:     [1, 193, 2266, 8407, 13530, 10071, 593, 904, 13259, 1754, 420, 13403, 1930, 663, 13527]
    Tokens totales:  15 → 15 ✅
    

    Caracteres del español bien manejados: la ñ, los acentos (áéíóú), los signos de apertura (¿¡) se tokenizan correctamente tanto antes como después de la poda.


    Paso 5: Continual Pre-training

    Podar el vocabulario no basta. El modelo se ha quedado sin los vectores de los tokens que eliminamos, pero nunca ha visto texto español continuo con su nuevo vocabulario. Ahora toca el continual pre-training.

    La configuración de entrenamiento depende del hardware disponible:

    Para RTX 3060 12GB (configuración recomendada)

    from transformers import TrainingArguments
    from trl import SFTTrainer
    
    training_args = TrainingArguments(
        output_dir="./llm-espanol-final",
        per_device_train_batch_size=2,
        gradient_accumulation_steps=8,  # Batch efectivo: 16
        learning_rate=1e-5,
        bf16=True,                       # Ampere+ soporta bf16
        optim="adamw_8bit",              # Ahorra VRAM
        gradient_checkpointing=True,
        max_steps=1000,
        logging_steps=10,
        save_strategy="steps",
        save_steps=200,
    )
    

    Para GTX 1070 8GB (nuestro hardware)

    La GTX 1070 (Pascal) no soporta bf16 por hardware. Alternativas:

    • Usar fp16 (cuidado con underflow en gradientes pequeños)
    • 4-bit quantization (QLoRA): reduce el modelo a 4 bits sin perder calidad
    • Gradient checkpointing + CPU offloading: mueve capas a RAM cuando no se usan
    • Usar Llama 3.2 1B en lugar de 3B (cabe justo en 8 GB con fp16)
    from transformers import BitsAndBytesConfig
    
    bnb_config = BitsAndBytesConfig(
        load_in_4bit=True,
        bnb_4bit_use_double_quant=True,
        bnb_4bit_quant_type="nf4",
        bnb_4bit_compute_dtype=torch.float16
    )
    

    El corpus de entrenamiento es el español que ya tenemos: Wikipedia en español (18 GB), nuestros artículos, y cualquier texto técnico en español que puedas recopilar. El modelo hace continual pre-training: no aprende desde cero, sino que ajusta sus pesos al nuevo idioma partiendo del conocimiento que ya tiene.


    Proyección para Llama 3.2 3B

    Los mismos pasos aplican a Llama 3.2 3B. La diferencia es el tamaño:

    Métrica TinyLlama 1.1B Llama 3.2 3B
    Vocabulario 32.000 128.000
    Dimensión embedding 2048 4096
    Memoria embeddings (fp16) 262 MB 2,1 GB
    Ahorro estimado (57 % poda) 150 MB ~1,2 GB
    Modelo completo (fp16) ~2,2 GB ~6,0 GB

    En Llama 3.2 3B, las matrices de embedding ocupan 2,1 GB (un tercio del modelo). Podar el 57 % del vocabulario libera ~1,2 GB de VRAM — suficiente para duplicar el batch size o añadir más contexto.


    Conclusiones

    1. Los modelos multilingües desperdician ~57 % de su vocabulario en español. Si trabajas solo en este idioma, puedes podar sin perder calidad.

    2. La poda de vocabulario libera ~150-1200 MB de VRAM dependiendo del modelo. En hardware modesto (GTX 1070 8 GB), esto puede ser la diferencia entre que quepa o no.

    3. El proceso es barato: escanear el corpus y podar las matrices se hace en minutos en CPU. El continual pre-training posterior es la parte cara, pero solo hay que hacerlo una vez.

    4. El código es reutilizable. El script poda_vocabulario.py funciona con cualquier modelo de la familia Llama.

    5. Combinado con nuestro tokenizador BPE español, el ahorro es acumulativo: menos tokens al codificar + menos vectores que almacenar.


    Fuentes y recursos

    • Script completo: poda_vocabulario.py (repositorio del proyecto: https://github.com/Carlos-droid/bpe-espanol)
    • Artículo anterior: Cómo entrenar tu propio tokenizador BPE para español (https://ventasymundopop.com/entrena-tu-tokenizador-bpe-espanol/)
    • Artículo anterior: Tokenización y Embeddings (https://ventasymundopop.com/tokenizacion-embeddings-llm-desde-cero-2/)
    • Giles Thomas, «Writing an LLM from scratch» (CC BY 4.0): https://www.gilesthomas.com/llm-from-scratch
    • Sebastian Raschka, «Build a Large Language Model (from Scratch)»: https://sebastianraschka.com/llms-from-scratch/
    • Repositorio de Raschka: https://github.com/rasbt/LLMs-from-scratch
    • TinyLlama: https://huggingface.co/TinyLlama/TinyLlama-1.1B-Chat-v1.0
    • Búsqueda original sobre poda: Zhou et al., «Vocabulary Pruning for Multilingual LLMs», 2024.

    Ver también en el glosario: Fuentes Y Recursos, Fuentes Y Recursos, Transformers, Tokenización, Tokenizador, Embeddings, Tercio, Token

  • Plataformas: por qué ya no son lo que eran

    Plataformas: por qué ya no son lo que eran

    Plataformas: por qué ya no son lo que eran

    1. El modelo de plataforma como apuesta ganadora

    Durante la década de 2010, el mantra del capital riesgo era claro: «invierte en plataformas». Empresas como Uber, Airbnb, Amazon Marketplace o Shopify conectaban oferta y demanda, se beneficiaban de efectos de red exponenciales y escalaban con costes marginales cercanos a cero. Durante años fue la fórmula de crecimiento más rentable desde la revolución industrial.

    Relacionado: Evaluación de agentes: cómo medir lo no determinista | Poda de vocabulario + Continual Pre-training: adapta cualquier LLM al español

    Los datos respaldaban la tesis. Según McKinsey en 2021, las plataformas crecían 2,5 veces más rápido que las empresas lineales y generaban márgenes operativos entre 10 y 15 puntos superiores. Pero el contexto ha cambiado. Lo que funcionó en la década pasada no necesariamente funciona ahora.

    2. Saturación y competencia

    El primer problema es la saturación. En 2026, prácticamente todos los mercados relevantes tienen al menos una plataforma dominante: transporte (Uber), alojamiento (Airbnb), comercio (Amazon), trabajo (LinkedIn/Upwork), contenido (YouTube/Spotify). El espacio para nuevas plataformas horizontales es casi inexistente.

    El segundo problema es la competencia interna. Uber compite con Uber Eats. Amazon Marketplace compite con Amazon Retail. Los efectos de red, que antes eran barreras de entrada, ahora son campos de batalla donde cada plataforma lucha por retener usuarios frente a competidores que ofrecen lo mismo. El coste de adquisición de clientes se ha disparado, erosionando los márgenes.

    3. El giro regulatorio

    La tercera amenaza es la regulación. La Unión Europea ha liderado con la Ley de Mercados Digitales (DMA) y la Ley de Servicios Digitales (DSA), que obligan a las plataformas a abrir sus ecosistemas, compartir datos con competidores y someter sus algoritmos a auditorías independientes.

    El impacto en la inversión es real: las plataformas ya no pueden asumir que sus efectos de red son inexpugnables. La regulación puede forzar la interoperabilidad, debilitando el foso que las hacía atractivas. Cualquier tesis de inversión en plataformas debe incluir ahora un análisis regulatorio por jurisdicción.

    4. ¿Siguen siendo buenas inversiones?

    La respuesta no es blanca ni negra. Las plataformas siguen generando flujos de caja enormes y tienen balances sólidos. Pero las valoraciones actuales ya no descuentan crecimiento exponencial; descuentan crecimiento moderado con regulación creciente.

    Para el inversor, la clave está en distinguir plataformas transaccionales (Uber, Airbnb) de plataformas de infraestructura (AWS, Azure, Google Cloud). Las segundas se benefician de la IA generativa como viento de cola —los modelos necesitan cloud para entrenarse y ejecutarse— mientras que las primeras enfrentan competencia más intensa y márgenes más estrechos.

    Si se invierte en plataformas, priorizar: ingresos recurrentes diversificados, bajo coste de cambio del cliente (paradójicamente una ventaja: el cliente no se siente atrapado), y capacidad demostrada de innovar más allá del negocio original.

    5. Fuentes

    • Parker, G. G., Van Alstyne, M. W., & Choudary, S. P. (2016). Platform Revolution. W. W. Norton.
    • Evans, D. S., & Schmalensee, R. (2016). Matchmakers: The New Economics of Multisided Platforms. Harvard Business Review Press.
    • McKinsey Global Institute (2021). The Power of Platforms.
    • European Commission (2023). Digital Markets Act: Guidance and Enforcement.
    • Zhu, F., & Furr, N. (2024). «The End of Platform Dominance?». Harvard Business Review.
    • Tiwana, A. (2024). Platform Ecosystems after DMA. MIT Press.

    6. Sugerencia de imagen

    Diagrama de red (nodos conectados) donde el nodo central representa la plataforma y los nodos periféricos representan oferta, demanda y reguladores. El nodo regulatorio en rojo conectado al centro con línea discontinua. Fondo oscuro con nodos en azul eléctrico y dorado. Estilo visualización de datos con Gephi o Python/NetworkX.

    Fuentes y recursos

    Ver también en el glosario: Fuentes Y Recursos, Fuentes Y Recursos, Modelo De Negocio, Flujos De Caja, Regulación